Проверка уникальности текста это поиск совпадений вашего текста с уже опубликованными страницами. Сервис режет текст на короткие фрагменты, ищет их в интернете и считает, какая доля фрагментов нигде не встретилась. Эта доля и есть процент уникальности. Способов проверки три: онлайн-сервис для статей (Content-Watch, Text.ru, Адвего, eTXT), платный антиплагиат для учебных работ (Антиплагиат.ру) и ручной поиск фразы в кавычках в Яндексе или Google. Первый подходит для блога и сайта, второй для курсовых и статей в журналы, третий для быстрой проверки одной подозрительной фразы. Важно понимать границу: процент уникальности говорит только о том, нашлись ли копии. О пользе и качестве текста он не говорит ничего, и поисковики оценивают именно пользу.
Что показывает процент уникальности
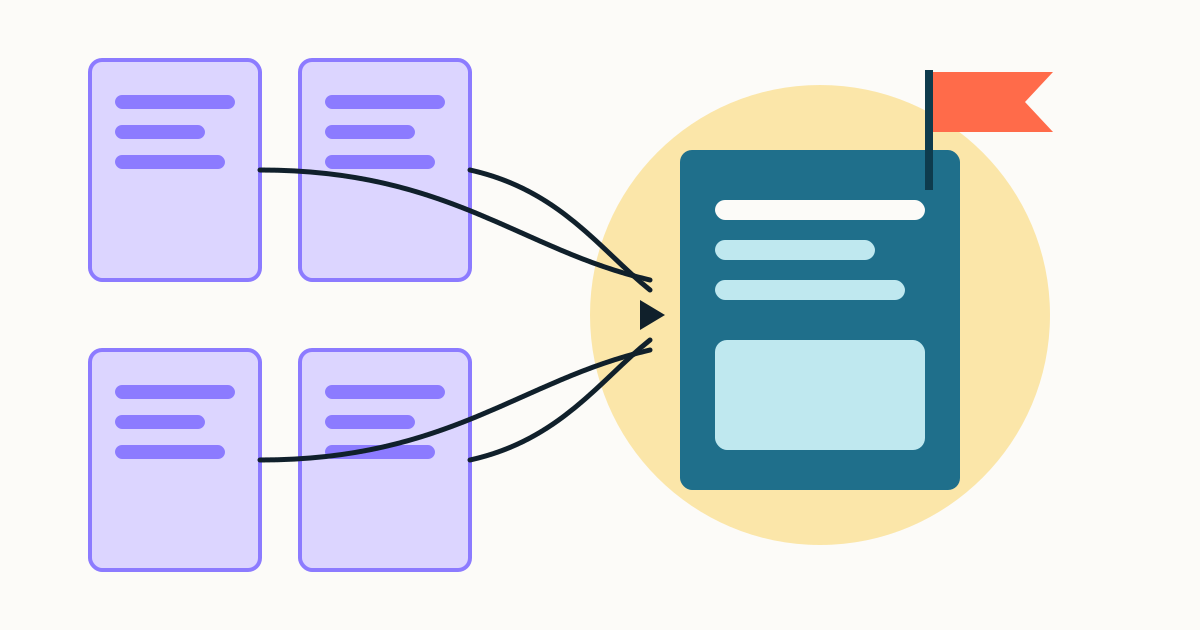
Большинство сервисов работают похоже. Текст делится на перекрывающиеся цепочки из нескольких слов подряд (их называют шинглами). Сервис отправляет эти цепочки в поиск, собирает страницы с совпадениями и сравнивает их с вашим текстом. В отчёте вы видите три вещи:
- Общий процент уникальности. Сколько фрагментов не нашлось нигде.
- Список страниц с совпадениями. Для каждой указан процент: какая доля вашего текста совпала с этой страницей.
- Подсветка в тексте. Какие именно фразы совпали.
Главный вывод: процент зависит от того, что сервис успел найти. Страницу, которую ещё не проиндексировали поисковики, сервис не увидит. Поэтому один и тот же текст в разных сервисах получает разные цифры, а повторная проверка через неделю может дать меньше, если вашу статью уже скопировали.
Схема 1. Как сервис превращает текст в процент уникальности. Слабое место всех сервисов в третьем шаге: они видят только то, что нашёл поиск.
Способ 1: онлайн-сервисы для статей
| Что | Когда подходит | Чем платите | Почему важно |
|---|---|---|---|
| Content-Watch | Разовая проверка статьи до 10 000 символов без регистрации, до 3 проверок в день | Бесплатно в пределах лимита, подписка от 190 рублей в месяц | Показывает процент совпадения с каждой найденной страницей, видно первоисточник |
| Text.ru | Регулярные проверки, когда нужен ещё SEO-анализ и орфография в одном отчёте | Гостевая проверка бесплатна, но идёт в общей очереди. PRO-аккаунт от 4 800 рублей (тариф «Базовый», 25 000 символов в день) | Гостевые лимиты на странице не указаны, после регистрации ограничения для гостей снимаются |
| Адвего | Длинные тексты, до 95 000 символов за одну проверку | Бесплатные символы начисляются ежедневно после активации аккаунта, сверх них символы покупаются | Программа Плагиатус больше не поддерживается (с 2023 года), работайте через онлайн-версию |
| eTXT | Пробная проверка небольшого текста без регистрации | 1 проверка до 3 000 символов бесплатно, дальше 1,30 рубля за 1 000 символов; программа для Windows от 289 рублей в месяц | Есть проверка с детектором ИИ (1,50 рубля за 1 000 символов). На странице лимиты онлайн-проверки указаны в разных местах по-разному |
Что важно знать про очереди. Бесплатные проверки идут в общей очереди с другими пользователями. 14.11.2026 в 22:14 мы отправили 422 символа в гостевую проверку Text.ru и оказались 401-ми в очереди: результат пришёл примерно через 9 минут. Если текст нужен срочно, это аргумент за сервис с лимитом в день, а не за общую очередь.
Как не запутаться в символах
Лимиты считаются в символах, и сервисы считают их по-своему. Один и тот же абзац из Википедии Content-Watch посчитал как 424 символа, Text.ru как 422, Адвего как 423. Разница в один-два символа не важна, но если текст близок к лимиту, оставьте запас в 1-2%.
Способ 2: антиплагиат для учебных и научных работ
Почему не хватает Content-Watch или Text.ru. Вузовская система сверяет текст не только с открытым интернетом, но и со своими базами. Сервис для статей этих баз не видит, поэтому 90% в нём не гарантирует такой же результат на кафедре.
По странице Антиплагиат.ру на 14.11.2026 для частных пользователей есть три тарифа, каждый на одну проверку:
- «Мини»: 690 рублей, до 50 000 символов;
- «Стандарт»: 990 рублей, до 150 000 символов;
- «Премиум»: 1 690 рублей, до 2 000 000 символов.
Во всех тарифах заявлена проверка на заимствования и на ИИ-генерацию по полной базе. С апреля 2026 года частичные проверки доступны бесплатно и без регистрации, но краткий и полный отчёт можно скачать только после покупки. Сам сервис пишет, что результаты «такие же, как в вузе», однако у вуза могут быть подключены свои модули и коллекции, поэтому точный порог и состав проверки уточняйте у научного руководителя.
Способ 3: поиск фразы в кавычках
Этот способ бесплатный и без лимитов. Он хорош в двух случаях:
- Проверить одну подозрительную фразу. Например, автор сдал текст, и один абзац выглядит слишком гладко.
- Найти, кто скопировал вашу статью. Возьмите характерную фразу из своего текста, лучше с цифрой или названием, и поищите её в кавычках. Чтобы исключить свой сайт, в Google добавьте минус-оператор:
"ваша фраза" -site:вашсайт.ru.
Google в справке прямо описывает кавычки как поиск точной формулировки. Яндекс в материалах для рекламодателей (статья от 27.11.2025) пишет, что кавычки находят фразу в точном виде.
Ограничение: вручную вы проверите 5-10 фраз, а не весь текст. Для полной проверки нужен сервис из способа 1.
Как читать отчёт: пример с Википедией
Мы взяли определение SEO из Википедии (424 символа по счёту Content-Watch) и проверили его в бесплатном Content-Watch 14.11.2026. Подробно этот же пример разобран в статье про рерайт текста, здесь посмотрим на него как на отчёт.
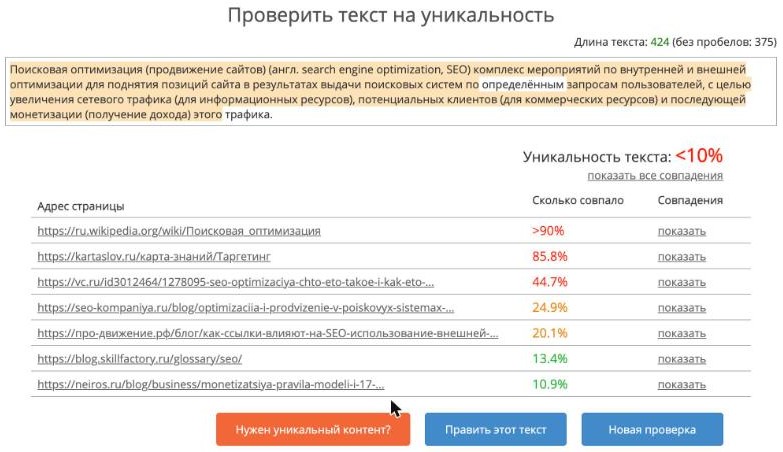
Проверка абзаца из Википедии в Content-Watch, 14.11.2026. Сервис нашёл первоисточник и 6 сайтов, которые использовали этот абзац.
Что видно в отчёте:
| Строка отчёта | Значение | Как читать |
|---|---|---|
| Уникальность текста | меньше 10% | Почти весь текст найден на других страницах |
| ru.wikipedia.org | больше 90% | Первоисточник: совпадение почти полное |
| Сайт-справочник | 85,8% | Скопировали почти целиком |
| Статья на vc.ru | 44,7% | Взяли часть определения |
| Ещё 4 сайта | от 24,9% до 10,9% | Использовали отдельные фразы или процитировали определение |
Тот же абзац в Text.ru получил уникальность 0%: сервис показал Википедию с совпадением 100% и блог на LiveJournal с совпадением 91%. Цифры у сервисов разные (меньше 10% и 0%), а вывод один: текст скопирован, первоисточник найден.
Отсюда практическое правило. Высокий процент совпадения с одной страницей означает копирование. Низкие проценты с многими страницами означают общие формулировки: термины, названия, устойчивые выражения. Их переписывать не нужно, иначе текст станет хуже. Цитаты с указанием автора тоже снижают уникальность, и это нормально.
Как повысить уникальность честно
Порядок, который работает:
- Найдите в отчёте источник с самым большим процентом. Обычно проблема в одном-двух абзацах, а не во всём тексте.
- Перепишите эти абзацы от вопроса читателя, а не от чужого текста: что он хочет узнать, в каком порядке.
- Добавьте то, чего нет у источника: свою цифру, скриншот, пример из практики, сравнение в таблице.
- Оформите цитаты и определения как цитаты с указанием источника. Это честно и понятно читателю.
- Проверьте ещё раз в том же сервисе, чтобы сравнивать сопоставимые цифры.
Синонимайзеры и «повышатели уникальности» дают обратный эффект. Google в правилах о спаме приводит как пример нарушения копирование чужого контента с небольшой правкой, например заменой синонимов. Яндекс в рекомендациях Вебмастера называет примером некачественного сайта ресурсы, которые «копируют или переписывают информацию с других ресурсов». Как писать текст, который не приходится «уникализировать», разбираем в статье как писать статьи для сайта.
Сколько уникальности нужно для поиска
Google отдельно пишет, что дублирование контента в пределах сайта нормально и не является нарушением правил о спаме. Если одна и та же страница доступна по нескольким адресам, Google сам выберет основную. Как управлять этим выбором, описано в статье про canonical.
Другое дело, когда ваш текст скопирован с чужого сайта или собран из чужих. Тогда у страницы нет причины стоять выше первоисточника. Высокий процент уникальности это технический минимум, а позиции зависят от ранжирования по сотням других сигналов. Проверить, не перегружен ли текст ключевыми словами и пустыми оборотами, можно отдельными инструментами: о них статья про воду и тошноту текста.
| Группа запросов | Запросов/мес | Доля |
|---|---|---|
| Уникальность текста: что это и чем проверять | 5 753 | 70,7% |
| Антиплагиат статьи и учебной работы | 1 559 | 19,2% |
| Как повысить уникальность текста | 820 | 10,1% |
| Всего | 8 132 | 100% |
Кому проверка уникальности не нужна
- Авторский текст из вашего опыта. Если вы не открывали чужие статьи во время работы, проверка найдёт только общие фразы. Достаточно выборочной проверки фразы в кавычках.
- Карточки товаров с техническими характеристиками. Модель, размеры, материал совпадут с сайтом производителя у всех магазинов. Уникальность здесь даёт описание опыта использования, отзывы и фото, а не перестановка цифр.
- Нормативные тексты: оферта, политика конфиденциальности, выдержки из законов. Переписывать их ради процента опасно для смысла.
- Оценка подрядчика только по проценту. Автор, который сдал 100% уникальности пересказом чужой статьи, сделал хуже автора с 85% и собственными данными.
Частые вопросы
Где проверить текст на уникальность бесплатно и без регистрации?
В Content-Watch: до 10 000 символов и до 3 проверок в день без регистрации. У eTXT без регистрации доступна одна проверка до 3 000 символов. Text.ru проверяет гостей бесплатно, но в общей очереди.
Какой процент уникальности считается нормальным?
Единого норматива нет ни у Яндекса, ни у Google. В техзаданиях на статьи часто ставят порог 80-90% в конкретном сервисе, но это договорённость заказчика и автора. Для учебных работ порог устанавливает вуз или журнал.
Почему разные сервисы показывают разную уникальность?
Они по-разному режут текст на фрагменты, ищут совпадения через разные поисковые источники и по-разному считают процент. Сравнивайте результаты одного сервиса во времени, а не цифры разных сервисов.
Можно ли проверить курсовую в Content-Watch вместо вузовского антиплагиата?
Можно для черновой проверки, но результат не совпадёт. Вузовская система сверяет текст и со своими базами, которых нет в открытом интернете.
Что делать, если мою статью скопировали?
Найдите копии поиском характерной фразы в кавычках, сохраните доказательства с датой публикации и напишите владельцу сайта или хостингу. Полезно, чтобы ваша страница попала в индекс раньше копии: как ускорить индексацию, описано в статье про индексацию сайта.
Источники
- Content-Watch: бесплатная проверка уникальности текста, лимиты
- Text.ru: проверка уникальности текста
- Text.ru: тарифы PRO-аккаунта
- Адвего: проверка уникальности, максимальный объём и Плагиатус
- eTXT: Антиплагиат, лимиты и цены
- Антиплагиат.ру: тарифы для частных пользователей
- Справка Google Поиска: как уточнить запрос (кавычки, минус, site:)
- Яндекс для бизнеса: операторы поиска Яндекса
- Google Search Central: правила в отношении спама (scraping)
- Google Search Central: канонизация и дублированный контент
- Яндекс Вебмастер: рекомендации, некачественный и неоригинальный контент