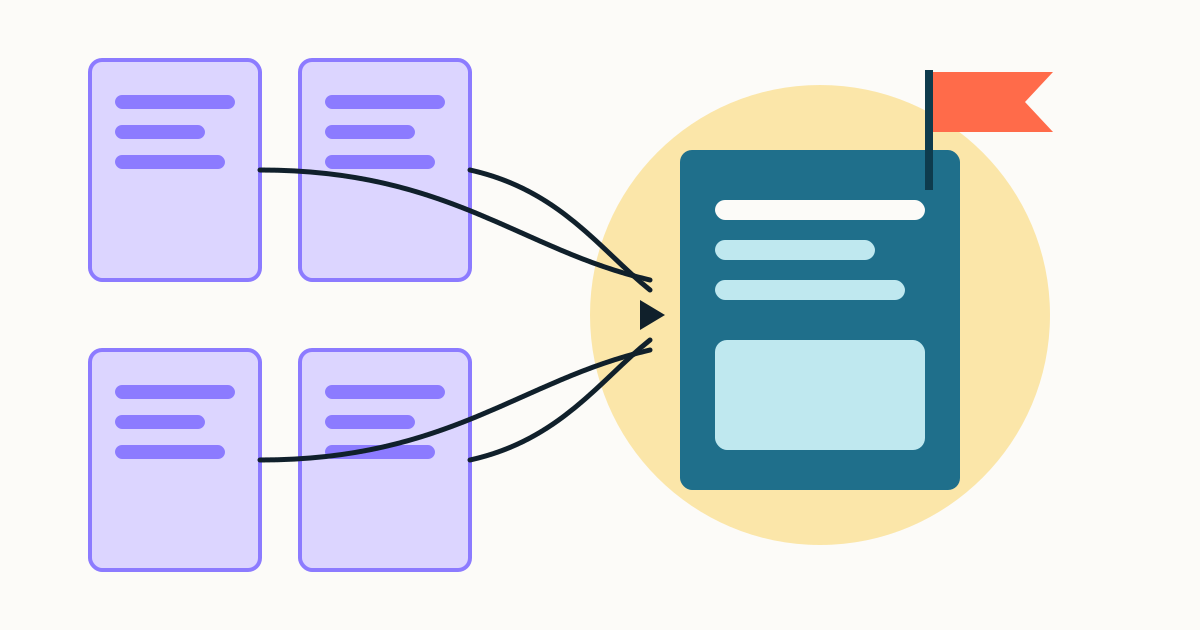
Дублем называют страницу, которая открывается по нескольким адресам с одинаковым или почти одинаковым содержимым: с www и без, со слэшем на конце и без, с UTM-метками, параметрами сортировки или фильтра. Яндекс объединяет такие адреса в группу и показывает в поиске один из них, Google выбирает канонический вариант. Проблема в том, что поисковик может выбрать не тот адрес, который нужен вам. Найти копии можно в трёх местах: «Индексирование → Страницы в поиске» в Яндекс Вебмастере, отчёт об индексировании страниц в Google Search Console и краулер вроде Screaming Frog. Убирают их 301 редиректом, атрибутом canonical, правилами для GET-параметров или закрытием от индекса.
Ниже порядок поиска, таблица причин и правило выбора способа. Сами инструменты подробно разобраны в отдельных статьях про canonical и редирект, здесь только как выбрать нужный.
Коротко
- В Вебмастере копии видны в списке исключённых страниц со статусом «Удалено: Дубль», в архиве выгрузки они помечены DUPLICATE.
- В Search Console о копиях говорят три статуса, например «Страница является копией. Канонический вариант не выбран пользователем».
- Screaming Frog показывает точные копии сразу, а похожие на 90% и больше только после Crawl Analysis; поиск похожих требует лицензии.
- Google не советует использовать robots.txt для выбора канонического адреса, а noindex для этой задачи не рекомендует.
- Страница, которую нужно убрать из поиска Яндекса, исчезает в течение трёх недель после повторного визита робота.
Откуда берутся копии одной страницы
| Источник копий | Пример адресов | Чем обычно лечат |
|---|---|---|
| Зеркала: протокол и www | http://site.ru/ и https://www.site.ru/ | 301 на главное зеркало |
| Слэш на конце | /catalog и /catalog/ | 301 на один вариант; Яндекс предупреждает, что canonical тут может не сработать |
| Несколько слэшей подряд | /catalog//item/ | 301, canonical или Disallow |
| Служебные файлы в адресе | / и /index.php | 301 на чистый адрес |
| Метки и параметры, не меняющие содержимое | /page/?utm_source=vk, ?sessionid= | Clean-param или настройка GET-параметров в Вебмастере, canonical для Google |
| Сортировка и вид каталога | ?sort=price, ?view=list | canonical на основной адрес раздела |
| Товар в нескольких разделах | /muzhskoe/kurtka-1/ и /sale/kurtka-1/ | Один постоянный адрес товара, остальные 301 или canonical |
| Версии для печати, AMP, мобильный поддомен | /print/page/, m.site.ru/page/ | canonical на основную версию |
Яндекс не считает копиями региональные поддомены с одинаковым содержимым. Для меток он, по справке, уже сам убирает большинство UTM-параметров, но служебные параметры вашего движка придётся описать вручную. Что такое UTM и зачем они нужны, разобрано в статье про UTM-метки, а как спроектировать адреса без лишних вариантов, в статье про ЧПУ.
Чем копии мешают сайту
Справка Яндекса перечисляет три последствия: нужная страница может пропасть из поиска, если робот выберет другую из группы; адрес в выдаче может смениться, что ломает аналитику; обход сайта замедляется и создаёт дополнительную нагрузку на сервер.
Google в документации о канонизации пишет, что указывать канонический адрес не обязательно: сайт, скорее всего, справится и без этого, потому что поисковик сам выбирает лучшую версию. Но выбор Google может не совпасть с вашим. На магазине с тысячами фильтров это значит, что в поиск попадёт адрес с параметром, а не чистый адрес раздела.
Отдельно стоит копирование чужого контента: это уже не техническая копия, а нарушение. Правила Google о спаме относят к нему перепубликацию материалов других сайтов без добавленной ценности.
Как найти копии в Яндекс Вебмастере
- Список исключённых. В разделе «Страницы в поиске» переключатель «Исключённые страницы» показывает до 50 000 адресов с причиной в колонке «Статус».
- Фильтр по статусу. Через значок фильтра выберите «Удалено: Дубль». Для большого сайта удобнее скачать архив: там такие строки помечены DUPLICATE.
- Группировка по шаблону. Отсортируйте выгрузку по адресу. Если копии отличаются одним и тем же хвостом (?sort=, /index.php, //), это одна причина и одно правило.
- Диагностика. Если копии вызваны GET-параметрами, Вебмастер показывает уведомление на странице «Диагностика сайта».
- Повторы title и description. Отчёт «Заголовки и описания» показывает, где title и description повторяются на большой доле страниц. Это не всегда копии, но часто подсказка. Как писать уникальные заголовки, разобрано в статье про title.
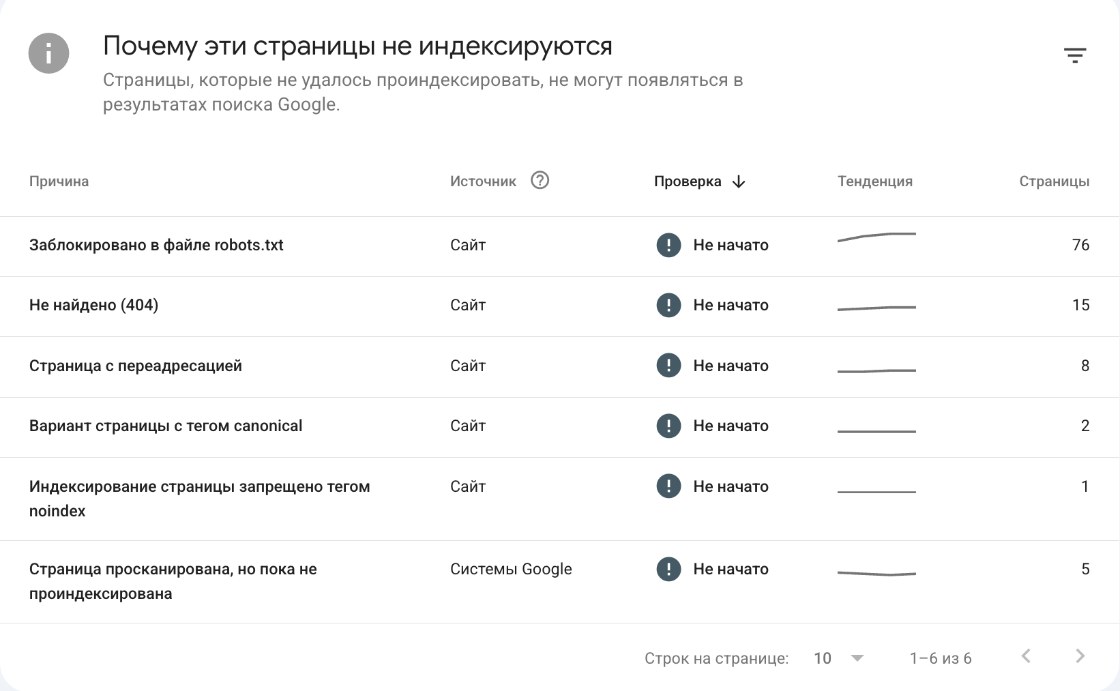
Отчёт «Страницы» в Search Console, tools.seoxl.ru, 14.11.2026. Строка «Вариант страницы с тегом canonical» и есть склеенные дубли: Google увидел копию и проиндексировал канонический адрес. Если вместо неё стоит «Страница является копией, канонический вариант не выбран пользователем», canonical на сайте нет или Google с ним не согласен. Исключённые страницы в Вебмастере в день съёмки были недоступны из-за технических работ Яндекса. Яндекс отдельно пишет, что само наличие исключённых страниц на позиции сайта не влияет. Смотрите не на число, а на то, есть ли среди копий адреса, которые вы хотели видеть в поиске. Обзор остальных отчётов есть в статье про Яндекс Вебмастер.
Как найти копии в Google Search Console
| Статус в отчёте | Что значит | Что делать |
|---|---|---|
| Страница является копией. Канонический вариант не выбран пользователем | Google нашёл копию и сам выбрал основной адрес | Если выбор верный, ничего; если нет, укажите canonical или поставьте 301 |
| Страница является копией. Канонические версии страницы, выбранные Google и пользователем, не совпадают | Вы указали canonical, но Google выбрал другой адрес | Сравните страницы: если ваш вариант заметно отличается по содержанию, Google его не примет |
| Вариант страницы с тегом canonical | Альтернативная версия правильно ссылается на основную | Ничего, это нормальное состояние |
Как подключить сайт и где находится отчёт, описано в статье про Search Console.
Как найти копии краулером
Что важно знать о Screaming Frog по его документации:
- Точные копии (Exact Duplicates) определяются во время обхода, отдельного анализа не нужно.
- Похожие страницы (Near Duplicates) появляются только после запуска Crawl Analysis. Порог сходства по умолчанию 90%, его можно снизить.
- Включение поиска похожих находится в Config > Content > Duplicates и требует лицензии. Бесплатная версия обходит до 500 адресов.
- Область сравнения. Меню и подвал программа исключает автоматически, а настроить, какие блоки сравнивать, можно в Config > Content > Area.
Как запустить первый обход, мы разбирали в статье про Screaming Frog. Краулер полезен ещё и тем, что показывает, откуда на сайте стоят внутренние ссылки на адреса-копии: их нужно заменить на основной адрес.
Как убрать копии: какой способ выбрать
Схема 1. Сначала решите, нужна ли копия человеку. От ответа зависит способ, а не от того, какой проще настроить.
| Что | Когда подходит | Чем платите | Почему важно |
|---|---|---|---|
| 301 редирект | Зеркала, слэши, index.php, старые адреса | Копия перестаёт открываться совсем | Самый сильный сигнал для Google и рекомендация Яндекса для копий без пользы |
| rel="canonical" | Копия нужна людям: сортировка, печать, AMP | Это подсказка: поисковик может её не принять | Сохраняет адрес для посетителей и сводит сигналы к основному |
| Clean-param или настройка GET-параметров | Параметры, не меняющие содержимое, в Яндексе | Работает только для Яндекса | Робот перестаёт обходить лишние адреса |
| noindex или Disallow | Служебные страницы: поиск по сайту, корзина, личный кабинет | Страница выпадает из поиска полностью | Google не советует так выбирать основной адрес среди копий |
Несколько деталей, в которых Яндекс и Google расходятся:
- robots.txt. Яндекс допускает Disallow для копий. Google пишет, что не стоит использовать robots.txt для канонизации: адрес, закрытый в robots.txt, может попасть в индекс без содержимого. Как правильно писать правила, разобрано в статье про robots.txt.
- GET-параметры. В Яндексе есть директива Clean-param, например
Clean-param: utm_source&utm_medium&utm_campaign /page, а с конца 2025 года ещё и инструмент «Индексирование → Настройка GET-параметров». Изменения в нём применяются в течение недели, а если он противоречит robots.txt, робот выполняет запрещающее правило. У Google такого инструмента нет, там работает canonical. - Карта сайта. Google считает включение адреса в Sitemap слабым сигналом канонизации, поэтому в карте должны быть только основные адреса. Подробно в статье про sitemap.xml.
После настройки замените внутренние ссылки, ведущие на копии, на основной адрес: иначе вы сами продолжаете подсказывать роботу неосновной вариант. Сроки тоже разные: по справке Яндекса страница пропадает из поиска в течение трёх недель после повторного обхода, на больших сайтах дольше.
Наши данные: как ищут эту тему
Методика. План MoreSEO, Яндекс Wordstat, Россия, 30 дней, срез 14.11.2026. Спрос темы равен сумме точных частот её запросов.
| Тема | Широкая | Точная | Доля точной в широкой | Спрос темы |
|---|---|---|---|---|
| Эта статья (главный запрос в H1) | 464 | 4 | 0,9% | 4 |
| Canonical | 2 124 | 177 | 8,3% | 229 |
| Редирект | 7 664 | 548 | 7,2% | 559 |
| 301 редирект | 856 | 128 | 15,0% | 176 |
Что из этого следует:
- Ищут лекарство, а не диагноз. Три темы об инструментах дают 964 запроса, тема о самой проблеме 4. Разница в 241 раз. Люди приходят к копиям уже с готовым решением в голове, хотя правильный способ зависит от причины.
- Почти весь спрос в длинных фразах. 99,1% широкой частотности (460 из 464) приходится на фразы с дополнительными словами, а не на два слова темы. Поэтому статья построена вокруг поиска и выбора, а не определения.
- Тема справочная. При спросе 4 запроса в месяц она нужна прежде всего как связка между аудитом, статьёй про canonical и статьёй про редиректы.
Когда этим можно не заниматься
- Маленький сайт на правильно настроенном движке. Проверьте зеркала и слэши один раз и возвращайтесь к теме при переезде.
- Статус «Вариант страницы с тегом canonical». Это не ошибка, а подтверждение, что разметка работает.
- Региональные поддомены с одинаковым текстом. Яндекс не считает их копиями, хотя для людей уникальное содержимое городов всё равно полезнее. Для магазинов с фильтрами тема шире, она разобрана в статье про SEO интернет-магазина.
Частые вопросы
Как быстро найти копии на сайте?
Откройте в Яндекс Вебмастере «Индексирование → Страницы в поиске», переключитесь на исключённые страницы и отфильтруйте статус «Удалено: Дубль». В Search Console посмотрите статусы «Страница является копией» в отчёте об индексировании страниц.
Что лучше: 301 или canonical?
Если копия не нужна посетителю, 301: это сильный сигнал, и копия перестаёт открываться. Если копия нужна людям (сортировка, метки, версия для печати), canonical.
Можно ли закрыть копии в robots.txt?
Для Яндекса можно, он допускает Disallow и Clean-param. Google не рекомендует robots.txt для выбора основного адреса: закрытый адрес может попасть в индекс без содержимого.
Наказывают ли поисковики за технические копии?
В правилах обоих поисковиков технических копий среди нарушений нет. Яндекс пишет, что исключённые страницы не влияют на позиции, а Google сам выбирает основную версию. Санкции касаются копирования чужого контента без добавленной ценности.
Источники
- Яндекс Вебмастер: дублирование страниц, как найти и исправить
- Яндекс Вебмастер: «Страницы в поиске» и исключённые страницы
- Яндекс Вебмастер: настройка GET-параметров
- Google Search Central: как указать канонический адрес среди похожих страниц
- Справка Search Console: отчёт об индексировании страниц
- Screaming Frog: как проверить сайт на дублированный контент
- Google Search Central: правила о спаме, раздел о скопированном контенте