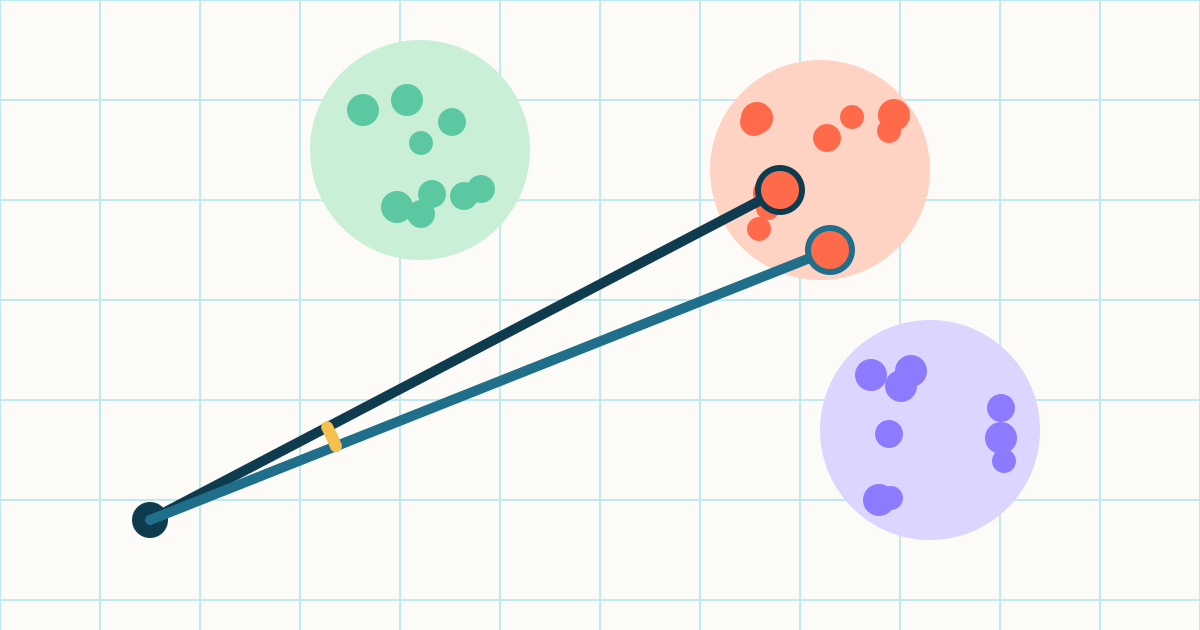
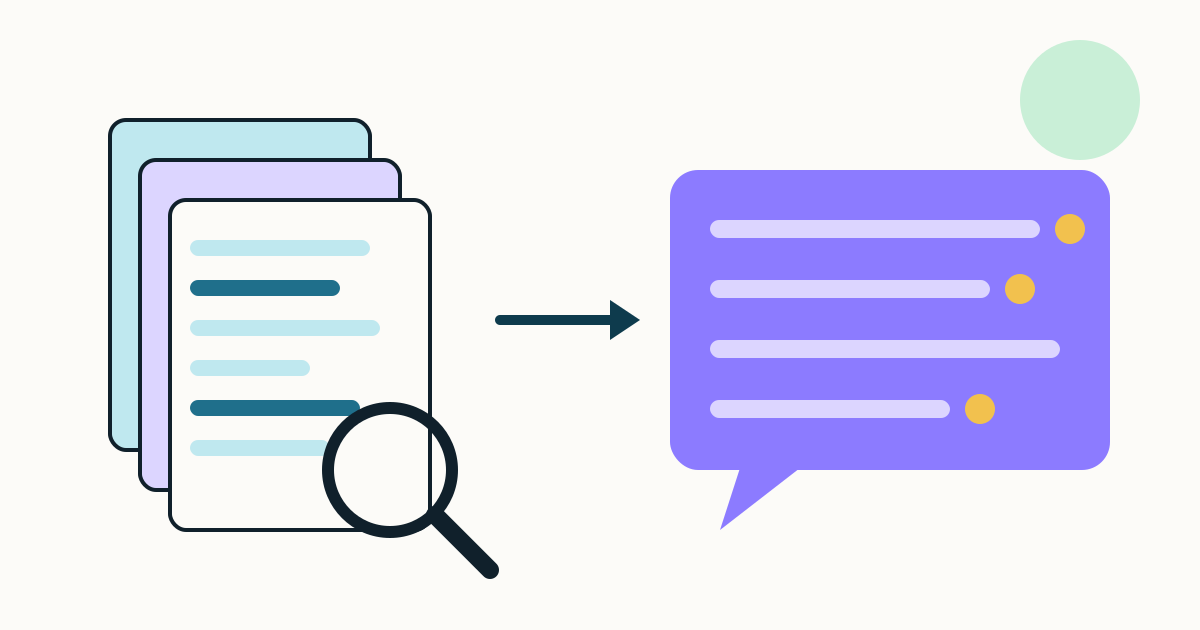
Умный поиск на сайте это строка поиска, которая понимает смысл запроса, а не только совпадение слов. Технически это гибридный поиск: лексический индекс находит точные совпадения (артикулы, модели, термины), векторный по эмбеддингам находит близкие по смыслу формулировки, результаты сливаются в один список. Для справочных разделов сверху добавляют генерацию: нейросеть собирает короткий ответ по найденным страницам и ставит ссылки на них. Это та же схема RAG, что и в нейропоиске, только по вашему собственному контенту.
Внедрять можно тремя путями: подключить генеративный ответ поисковика по своему сайту, собрать поиск на облачном индексе с готовым гибридным режимом или поставить специализированный сервис для интернет-магазинов.
Коротко
- Поисковый индекс Vector Store в Yandex AI Studio по умолчанию работает в гибридном режиме: векторный поиск плюс лексический.
- Генеративный ответ Yandex Search API можно ограничить до 5 сайтов, 5 хостов или 10 конкретных страниц, по умолчанию не больше одного запроса в секунду.
- Elastic рекомендует собирать гибридный поиск через алгоритм reciprocal rank fusion (RRF).
- По исследованию AnyQuery 2019 года на сайтах DIY-ритейла 14% покупателей вводят названия с ошибками, а 7% запросов дают пустую выдачу.
- Prompt injection стоит первой в списке OWASP Top 10 для LLM-приложений 2025 года.
Чем умный поиск отличается от обычной строки поиска
Пример с термокружкой взят из документации Algolia NeuralSearch: там векторные и ключевые результаты извлекаются отдельно и сводятся в одну шкалу. Как устроены векторы, разобрано в статье про эмбеддинги, а сам принцип «найти, потом сгенерировать» в статье про RAG.
| Что | Когда подходит | Чем платите | Почему важно |
|---|---|---|---|
| Полнотекстовый поиск с морфологией | Небольшой каталог, люди ищут по точным названиям и артикулам | Ручные синонимы и словарь опечаток, пустая выдача на описательные запросы | Дёшево, предсказуемо, артикулы находит идеально |
| Векторный поиск | Описательные запросы: «платье на свадьбу летом», «как вернуть товар» | Хуже с артикулами и редкими терминами; нужна модель эмбеддингов | Находит то, что названо другими словами |
| Гибридный поиск | Почти любой каталог и база знаний от нескольких сотен документов | Сложнее настройка слияния и весов, два индекса | Точные совпадения и смысловые в одной выдаче |
| Генеративный ответ поверх поиска | Справка, база знаний, условия доставки и возврата | Оплата генерации, риск ошибок в ответе и инъекций | Человек получает ответ, а не десять ссылок |
Как это устроено внутри
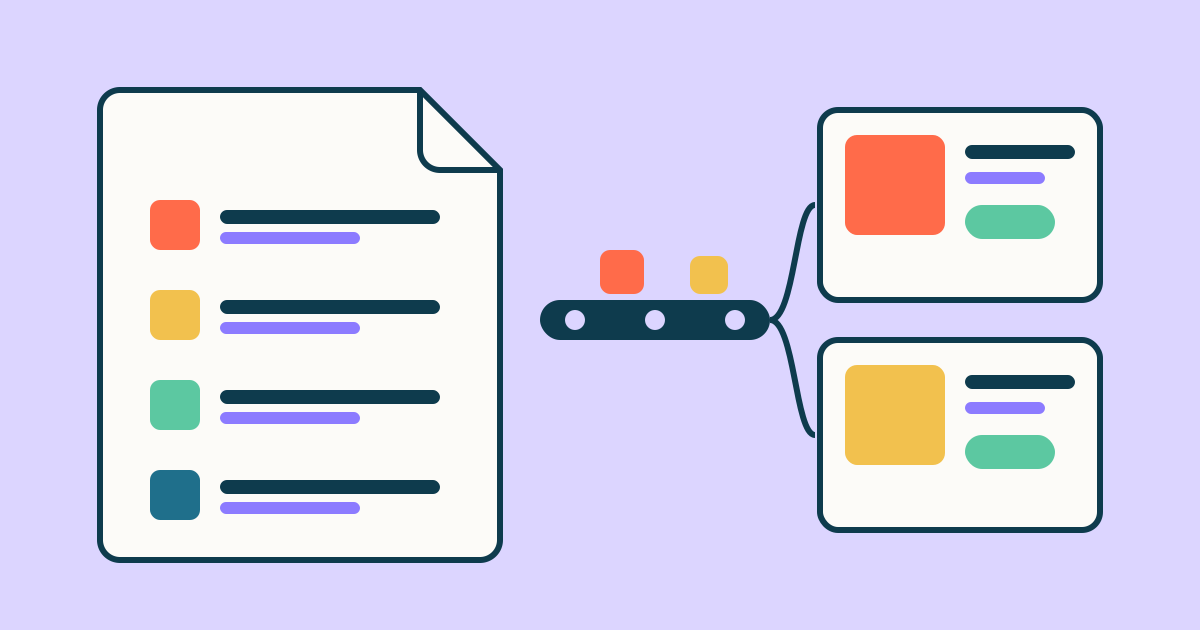
Схема 1. Одна поисковая основа, два выхода: каталогу нужен список товаров, справке нужен ответ со ссылками.
Слияние обычно делают через RRF: документ, который высоко стоит хотя бы в одном из списков, получает прибавку к итоговому месту. Elastic прямо рекомендует этот алгоритм для гибридного поиска. В Algolia похожую роль играют пресеты смешивания, от осторожного до расширенного охвата.
Что важно для каталога товаров
- Артикулы и коды. Лексическая часть гибридного поиска нужна именно для них. Векторы плохо различают «X200» и «X300».
- Опечатки и раскладка. В исследовании AnyQuery (2019, 3 млн сессий DIY-магазинов) 14% покупателей вводили названия с ошибками, а 7% поисков заканчивались пустой страницей. Пустая выдача это первое, что нужно мерить.
- Фильтры из запроса. «Синий диван до 50 тысяч» стоит разобрать на категорию, цвет и цену и применить фильтры, а не искать похожие тексты.
- Данные из фида. Источник истины это товарный фид или база, а не описание на странице. Как готовить фид, разобрано в статье про товарные фиды.
- Ничего не генерировать о товаре. Если показываете короткую подсказку от нейросети, проверяйте, что в ней нет цен и сроков, которых нет в карточке.
Что важно для базы знаний и справки
Как резать страницы на фрагменты, какие метаданные добавлять и как обновлять базу, подробно описано в статье про базу знаний для RAG. Здесь три правила, которые касаются именно поиска:
- Ответ со ссылками. Каждое утверждение в ответе ведёт на страницу, откуда оно взято. Так человек может проверить, а вы видите, какие статьи реально работают.
- Порог релевантности. Если лучшие найденные фрагменты слабо похожи на запрос, показывайте обычную выдачу или «не нашли», а не генерацию. Это главная защита от галлюцинаций.
- Свежесть. Условия доставки, цены услуг и сроки меняются. Фрагменты с такими данными должны обновляться вместе с исходной страницей.
Какие есть готовые решения
| Решение | Что даёт | Ограничения из документации |
|---|---|---|
| Yandex Search API, генеративный ответ | Ответ нейросети по результатам поиска Яндекса на указанных сайтах | Только синхронный режим; до 5 сайтов, или до 5 хостов, или до 10 страниц; по умолчанию 1 запрос в секунду |
| Yandex AI Studio, Vector Store | Свой поисковый индекс по файлам для агента с инструментом file_search | Гибридный режим по умолчанию; до 10 000 файлов, файл до 128 МБ, фрагмент в JSONL до 8 000 символов |
| Algolia NeuralSearch | Векторный слой поверх ключевого поиска, вкладка сравнения и A/B-тесты | Доступен не на всех тарифах; проверьте условия для вашей компании |
| Elasticsearch или OpenSearch | Гибридный поиск на своём сервере, полный контроль данных | Нужна команда, которая настроит индексы, модели и слияние |
| Сервисы для магазинов: AnyQuery (ранее Diginetica), Multisearch | Поиск по каталогу как услуга, подключение через фид или API | Функции и цены уточняйте у сервиса: публичной документации по ним мало |
Важная деталь генеративного ответа Яндекса: он строится по результатам текстового поиска Яндекса, то есть по тем страницам, которые есть в его индексе. Если раздел закрыт от индексации или страницы ещё не проиндексированы, ответа по ним не будет. Подключение к моделям через API разобрано в статье про API нейросетей.
Как не открыть дыру для инъекций
Практические правила:
- Не добавляйте в индекс для генерации пользовательский контент без модерации: отзывы, вопросы, тексты продавцов на маркетплейсе.
- Поиск только читает. Никаких функций «оформить заказ» или «изменить данные» у модели в поиске быть не должно.
- Фильтруйте ответ: если в нём ссылка на чужой домен, телефон или промокод, которых нет в исходных фрагментах, не показывайте его.
Подробно о слоях защиты в статье про prompt injection.
Как умный поиск связан с SEO
- Логи как семантика. Запросы с пустой выдачей или без кликов показывают пробелы в ассортименте и контенте. Их стоит сверить со спросом в Вордстате, прежде чем делать новую категорию.
- Выдачу поиска закрывайте. Google советует блокировать в robots.txt неважные для поиска адреса, например разные сортировки одной страницы. Страницы внутреннего поиска с параметрами закрывают по той же логике. Как это сделать без ошибок, в статье про robots.txt.
- Не генерируйте страницы из запросов автоматически. Тысячи страниц под каждый запрос из логов это путь к дорвеям, а не к трафику.
Как запустить пилот
Четыре метрики, которых достаточно для решения:
- Доля запросов с пустой выдачей.
- Доля поисков с кликом по результату.
- Доля переформулировок: человек сразу ищет ещё раз.
- Конверсия из поиска в заказ или заявку для каталога, доля ответов с правильной ссылкой для справки.
Если новый поиск выигрывает на наборе, включите его на часть трафика через A/B-тест и сравните те же метрики.
Наши данные: как ищут эту тему
Методика. Яндекс Wordstat, Россия, 30 дней, срез 14.11.2026, из семантического ядра блога.
| Запрос | Широкая | Точная | Доля точной |
|---|---|---|---|
| «ии поиск» (общая тема нейропоиска) | 29 652 | 703 | 2,4% |
| Тема этой статьи | 241 | 7 | 2,9% |
- Тема почти не ищется дословно. 7 запросов в месяц, это 0,5% от спроса общей темы ИИ-поиска (1 291 по сумме точных частот группы).
- Широкая частотность в 34 раза больше точной. В неё попадают все запросы, где есть эти слова в любом порядке, в том числе про поиск сайтов нейросетью. Владельцы сайтов, которым нужен поиск, чаще ищут конкретные сервисы или спрашивают разработчиков.
Поэтому статья справочная: она нужна тем, кто уже решил внедрять, и для перелинковки с темами RAG и защиты ассистентов.
Кому это не подходит
- Сайт-визитка и небольшой блог. Хватит меню, хорошей структуры и обычного поиска.
- B2B-каталог по кодам деталей. Полнотекстовый поиск с точным совпадением сработает лучше векторного.
- Нет логов поиска. Сначала начните их собирать, иначе вы не узнаете, стало ли лучше.
Частые вопросы
Можно ли сделать умный поиск без программиста?
Частично. Специализированные сервисы для магазинов подключаются через фид и скрипт. Генеративный ответ Yandex Search API и индекс AI Studio требуют работы с API, это задача разработчика.
Чем умный поиск отличается от чат-бота?
Поиск отвечает на один запрос и показывает источники, чат-бот ведёт диалог. Под капотом у обоих может быть одна и та же база и один и тот же гибридный поиск.
Нужна ли векторная база данных?
Не обязательно. Облачные индексы вроде Vector Store в AI Studio и сервисы поиска уже включают векторный слой. Отдельная база нужна, если вы собираете поиск сами.
Будет ли поиск выдумывать товары и цены?
Может, если разрешить модели писать о товарах свободно. Цены, наличие и характеристики показывайте только из каталога, а генерацию оставьте для понимания запроса и справочных ответов.
Источники
- Yandex Search API: генеративный ответ по сайтам, параметры site, host и url
- Yandex AI Studio: поисковые индексы Vector Store и гибридный режим
- Algolia: документация NeuralSearch
- Elastic: гибридный поиск и reciprocal rank fusion
- OWASP Top 10 для LLM-приложений 2025: LLM01 Prompt Injection
- Google Search Central: управление бюджетом сканирования
- New Retail: исследование AnyQuery о поиске в DIY-магазинах, 2019