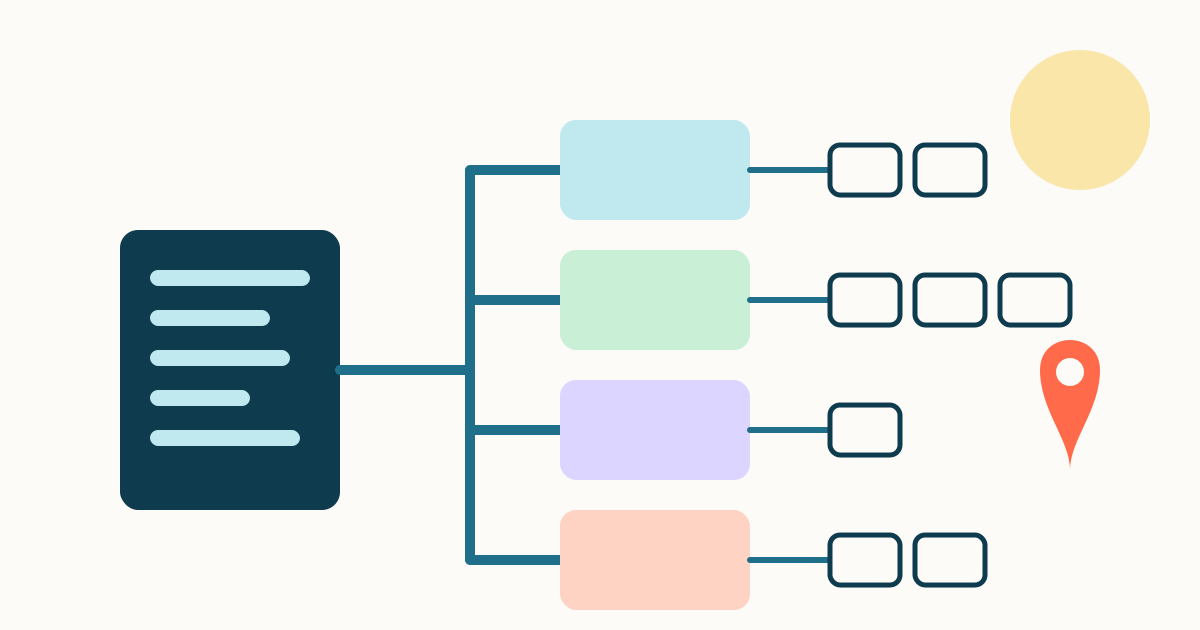
Поисковый робот, или краулер, это программа, которая обходит интернет: загружает страницу, находит на ней ссылки, ставит новые адреса в очередь и загружает их тоже. Собранные страницы поисковик обрабатывает, при необходимости выполняет JavaScript (рендерит) и решает, добавить ли их в индекс. У Google основной робот называется Googlebot, у Яндекса YandexBot. Кроме них у каждой системы десятки специализированных роботов: для картинок, видео, рекламы, проверки доступности.
Владелец сайта влияет на роботов тремя инструментами: robots.txt (куда ходить нельзя), sitemap (какие адреса важны) и качеством ответа сервера (как быстро и без ошибок отдаются страницы). Увидеть, что роботы делают на сайте, можно в отчётах Вебмастера и Search Console и в логах сервера.
Как страница проходит путь от ссылки до индекса
- Обнаружение. Адрес попадает в очередь из ссылок на других страницах, из sitemap.xml, из запроса в кабинете вебмастера.
- Сканирование. Робот проверяет robots.txt, запрашивает страницу и получает код ответа. Редирект, 404 или 5xx останавливают путь здесь.
- Рендеринг. Google выполняет JavaScript в отдельной очереди. Страница ждёт в ней несколько секунд, но может и дольше.
- Индексирование. Поисковик разбирает содержимое, выбирает канонический адрес среди дублей и решает, достойна ли страница места в индексе. Как дальше определяется порядок в выдаче, разбираем в статье про ранжирование.
Схема: четыре этапа и что ломается на каждом.
Если страница не появляется в поиске, сначала определите, на каком этапе она остановилась. «Не просканирована» и «просканирована, но не проиндексирована» лечатся по-разному: первое вопрос доступности и ссылок, второе вопрос качества и дублей. Пошаговый разбор в статье про индексацию сайта.
Какие роботы есть у Google
| Робот | Для чего | Что важно знать |
|---|---|---|
| Googlebot Smartphone и Googlebot Desktop | Сканирование для Google Поиска | Один токен в robots.txt: закрыть только мобильного или только десктопного робота нельзя. Различить их можно по заголовку User-Agent |
| Googlebot Image, Video, News | Картинки, видео, новости | Блокировка Googlebot затрагивает Поиск, Discover, Картинки, Видео и Новости |
| Google StoreBot | Страницы товаров, корзины, оформления заказа | Относится к общим краулерам Google |
| Google-InspectionTool | Проверка URL в Search Console и проверка расширенных результатов | Его визиты в логах это ваши ручные проверки |
| GoogleOther | Сканирование для внутренних задач Google, не для Поиска | Можно закрыть отдельно, на Поиск это не влияет |
| Google-Extended | Не робот, а токен: можно ли использовать контент для обучения Gemini | Google: не влияет на попадание в Поиск и ранжирование |
Лимиты Googlebot по текущей документации: первые 2 МБ поддерживаемого файла и первые 64 МБ PDF. Каждый ресурс страницы (CSS, JS) загружается отдельно с тем же лимитом 2 МБ. Всё, что за пределом, в индексирование не попадает. Для обычной страницы это огромный запас, но страница каталога с тысячами товаров, встроенными в HTML данными и инлайновыми картинками в base64 может его превысить.
Частота визитов: Google пишет, что для большинства сайтов Googlebot заходит в среднем не чаще одного раза в несколько секунд. Короткие всплески бывают, это нормально.
Какие роботы есть у Яндекса
*, а некоторые не используют robots.txt вовсе.Справка Яндекса перечисляет больше 40 агентов. Тех, что чаще всего видны в логах обычного сайта:
- YandexBot главный индексирующий робот, соблюдает robots.txt.
- YandexImages и YandexVideo индексируют картинки и видео.
- YandexRenderResourcesBot загружает ресурсы для рендеринга JavaScript. Он игнорирует robots.txt, если HTML-страница, которая их использует, доступна Яндексу.
- YandexMetrika несколько версий: проверка доступности страниц, кэширование CSS для Вебвизора. Часть из них robots.txt не использует.
- YandexAccessibilityBot проверяет доступность страниц для пользователей, не чаще трёх запросов в секунду.
- YandexAdditional не делает запросов: это имя для правил, ограничивающих показ контента в быстрых ответах с YandexGPT.
Важная деталь для настройки robots.txt: многие роботы Яндекса помечены в справке как не следующие общим правилам. Если хотите ограничить их, указывайте нужный User-agent по имени. Сравнение самих поисковиков есть в статье про поисковые системы.
Что такое рендеринг и почему он задерживает индексацию
Что следует из документации Google по JavaScript:
- Если исходный HTML содержит noindex, Google может вообще не выполнять JavaScript. Убрать noindex скриптом не получится.
- Страницы с кодом ошибки, например 404, могут не рендериться.
- Если CSS и JS закрыты в robots.txt, робот видит страницу не так, как пользователь.
Самый надёжный вариант для важного контента: серверный рендеринг или предварительная генерация HTML. Тогда текст и ссылки есть уже в первом ответе сервера, и этап рендеринга не критичен. Скорость ответа сервера тоже влияет на обход, подробнее в статье про скорость загрузки сайта.
Что такое краулинговый бюджет и кому о нём думать
Две составляющие по документации Google:
- Лимит пропускной способности. Сайт отвечает быстро и без ошибок: лимит растёт. Сайт тормозит, отдаёт 5xx или 429: Google снижает частоту запросов.
- Спрос на обход. Зависит от числа известных адресов, популярности страниц и того, как часто они меняются. Без подсказок Google пытается обойти все известные ему адреса, включая дубли.
Что съедает бюджет на практике: фильтры и сортировки, порождающие миллионы комбинаций адресов; цепочки редиректов; «мягкие» 404, когда пустая страница отвечает 200; бесконечные календари и пагинация.
| Что | Когда подходит | Чем платите | Почему важно |
|---|---|---|---|
| Disallow в robots.txt для мусорных параметров | Фильтры, сортировки, внутренний поиск | Закрытые адреса не передают сигналы, страница может остаться в индексе без описания | Робот перестаёт тратить запросы на дубли |
| Canonical и Clean-param | Дубли с метками и параметрами, которые должны склеиться | Робот всё равно загружает адреса, экономия меньше | Сигналы переходят на основной адрес |
| 404 или 410 для удалённых страниц | Товар снят навсегда, раздел удалён | Адрес уходит из поиска | Google реже возвращается к таким адресам |
| Ответ 304 Not Modified | Крупные сайты с редкими изменениями страниц | Нужна поддержка на сервере | Робот не скачивает заново неизменённую страницу |
Чего делать не стоит. Noindex не экономит бюджет: Google всё равно запрашивает страницу и только потом её отбрасывает. И не закрывайте разделы в robots.txt временно, надеясь «перекинуть» обход на другие страницы: Google пишет, что освободившийся бюджет перераспределится, только если сайт и так упирается в лимит нагрузки. У Яндекса скорость обхода регулируется отдельно: «Индексирование → Скорость обхода» в Вебмастере, значение там считается рекомендацией для робота.
Где посмотреть, что роботы делают на сайте
В Вебмастере отчёт показывает, сколько страниц робот обошёл с разбивкой по кодам ответа, список адресов с датой последнего обхода (до 50 000 страниц) и изменения кодов ответа. Данные обновляются ежедневно, в течение шести часов после визита робота.
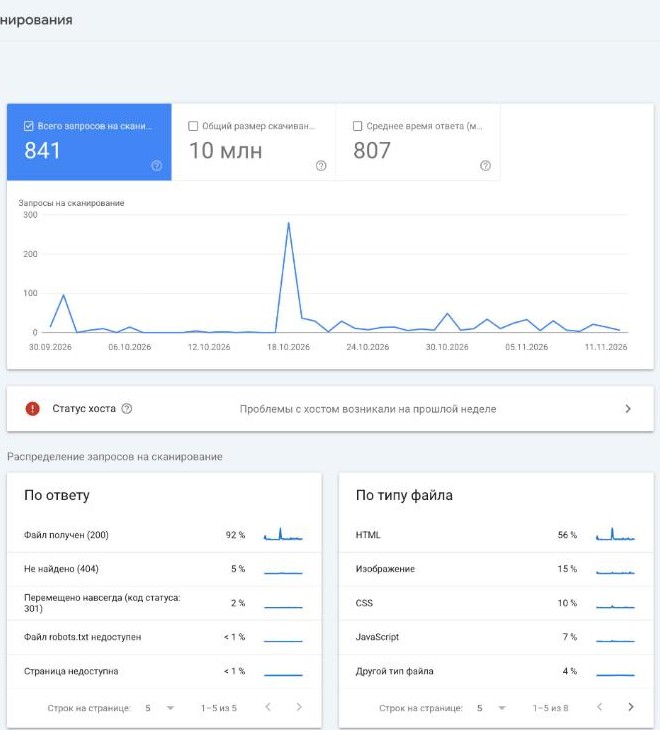
Search Console → «Настройки» → «Статистика сканирования» для tools.seoxl.ru, 14.11.2026: 841 запрос Googlebot за 90 дней, 92% ответов 200, 5% 404, 56% запросов к HTML. Аналогичный отчёт Вебмастера «Статистика обхода» в тот день был недоступен из-за технических работ Яндекса. В Search Console «Статистика сканирования» показывает число запросов, объём загруженных данных и среднее время ответа. Как подключить сам кабинет, описано в статье про Google Search Console. Для собственного аудита можно запустить и свой краулер, например Screaming Frog: он обходит сайт так же, как поисковый робот, и показывает, какие страницы недоступны по ссылкам.
Как проверить, что в логах настоящий Googlebot или YandexBot
Шаг 1. Найдите в логе запросы робота. Строка в формате Nginx выглядит примерно так:
66.249.66.1 - - [14/Nov/2026:10:02:11 +0300] "GET /catalog/ HTTP/1.1" 200 51234 "-" "Mozilla/5.0 (Linux; Android 6.0.1; Nexus 5X Build/MMB29P) ... (compatible; Googlebot/2.1; +http://www.google.com/bot.html)"
Шаг 2. Обратный запрос по IP.
host 66.249.66.1
1.66.249.66.in-addr.arpa domain name pointer crawl-66-249-66-1.googlebot.com.
Шаг 3. Прямой запрос по имени.
host crawl-66-249-66-1.googlebot.com
crawl-66-249-66-1.googlebot.com has address 66.249.66.1
IP совпал, имя на googlebot.com: робот настоящий.
Схема: четыре шага проверки подлинности робота.
| Поисковик | Допустимые домены в обратном DNS | Списки IP |
|---|---|---|
| googlebot.com, google.com, googleusercontent.com | Публикуются в JSON: common-crawlers.json для Googlebot, special-crawlers.json для AdsBot и других, отдельные файлы для запросов по действиям пользователей | |
| Яндекс | yandex.ru, yandex.net, yandex.com | Не публикуются: адреса часто меняются, роботы работают из AS13238, AS208722 и AS212066. В Вебмастере есть инструмент проверки IP |
Если имя хоста на другом домене или прямой запрос вернул другой IP, это не робот поисковика, а парсер с подставленным User-Agent. Такие запросы можно ограничивать на сервере без риска для индексации. То же правило касается ИИ-ботов: OpenAI и Perplexity публикуют IP своих роботов в JSON-файлах (ссылки в источниках).
Наши данные: как ищут роботов
Методика: точные частоты запросов темы в Яндекс Wordstat, Россия, 30 дней, срез 14.11.2026.
- Тема собирает 614 запросов в месяц: «краулер», «веб краулер», «googlebot».
- Это больше, чем у темы robots.txt (394) в 1,56 раза, но меньше, чем у темы sitemap (1 064).
- Три темы технического обхода вместе дают 2 072 запроса, на роботов приходится 29,6%.
Что из этого следует: о роботах чаще спрашивают через англоязычный термин и название конкретного робота Google, а не «поисковый робот Яндекса». Поэтому мы начали статью с определения и дали отдельный раздел про проверку Googlebot по логам: это задача, с которой человек приходит после того, как увидел имя робота в логе.
Кому не нужно разбираться глубже
- Сайт до нескольких тысяч страниц без фильтров. Краулинговый бюджет не ваша проблема. Если страницы не индексируются, причина почти всегда в качестве или дублях.
- Сайт на конструкторе. Логи сервера обычно недоступны; хватит отчётов Вебмастера и Search Console.
- Нет признаков подделки. Проверять каждого Googlebot в логах незачем, это нужно при подозрительной нагрузке или перед блокировкой по IP.
Частые вопросы
Чем поисковый робот отличается от парсера?
Технически ничем: все они автоматически ходят по ссылкам и загружают страницы. Разница в цели и правилах. Поисковый робот собирает страницы для индекса, соблюдает robots.txt и подтверждается обратным DNS. SEO-программы вроде Screaming Frog обходят сайт для аудита, парсеры собирают данные и часто подделывают User-Agent.
Как часто Googlebot заходит на сайт?
Google пишет, что для большинства сайтов в среднем не чаще одного раза в несколько секунд. Частота зависит от размера сайта, скорости ответа и того, как часто меняются страницы.
Можно ли попросить робота зайти на страницу?
Да. В Search Console это «Запросить индексирование» в инструменте проверки URL, в Яндекс Вебмастере «Переобход страниц». Оба инструмента ставят адрес в очередь, но не гарантируют индексацию.
Как снизить нагрузку от роботов на сервер?
Для Яндекса установите скорость вручную в «Индексирование → Скорость обхода». Google снижает частоту сам, если сайт отвечает 5xx или 429. Закрывать робота через 401 или 403 Google не рекомендует.
Видит ли робот контент, который загружается скриптом?
Google видит после рендеринга, но позже и не всегда: если в исходном HTML стоит noindex, скрипты могут не выполниться. Важный текст и ссылки надёжнее отдавать в HTML сразу.
Источники
- Google Search Central: Googlebot, лимиты 2 МБ и 64 МБ, частота визитов
- Google: общие краулеры, включая Googlebot, GoogleOther и Google-Extended
- Google: как проверить, что запрос пришёл от Google
- Google: управление краулинговым бюджетом на больших сайтах
- Google Search Central: основы JavaScript SEO и этап рендеринга
- Яндекс Справка Вебмастера: роботы Яндекса и проверка по обратному DNS
- Яндекс Справка Вебмастера: статистика обхода
- Яндекс Справка Вебмастера: скорость обхода сайта
- RFC 9309: Robots Exclusion Protocol
- OpenAI: роботы и списки IP
- Perplexity: PerplexityBot и списки IP