Готовое ядро выглядит как таблица в Excel или Google Таблицах, где каждая строка это один запрос, а колонки фиксируют решения по нему: частотность широкая и точная, интент, кластер (группа запросов для одной страницы), адрес этой страницы и приоритет. Обычно в файле 3–5 листов: сырые фразы, минус-слова, само ядро, карта страниц и лист с методикой, где записаны регион, период и дата среза. Главный признак рабочего файла: по любой строке понятно, куда ведёт запрос и почему.
Ниже два образца. Первый на вымышленной нише, цифры в нём условные. Второй это реальный кусок семантики блога MoreSEO с частотностями из Wordstat на 14.11.2026.
Коротко
- Обязательные колонки: запрос, точная частотность, интент, кластер, URL. Без URL файл не превращается в план работ.
- Широкую частотность хранят для ориентира, но не складывают: в нашем кластере у запроса «ключевые слова» точная частота 2 008 составляет всего 0,7% от широкой 282 350.
- Спрос кластера считают суммой точных частот его запросов.
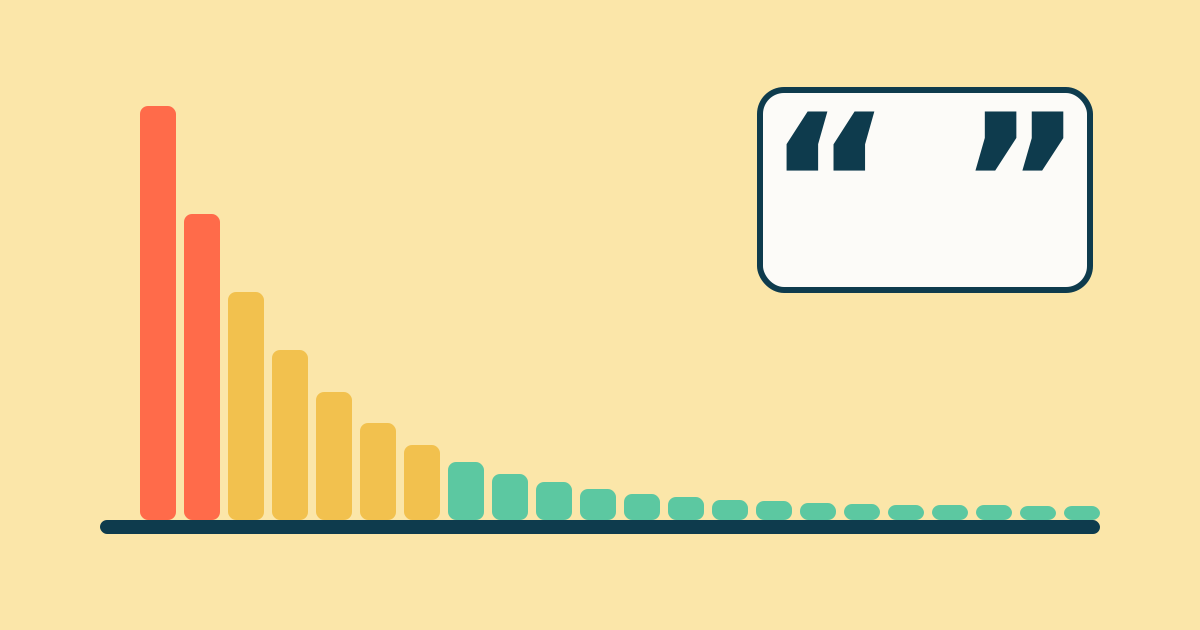
- В реальном кластере из 15 тем три самые крупные собрали 79,4% спроса, семь нишевых всего 1,6%.
- Вебмастер Яндекса показывает спрос как среднемесячное значение за прошлый год, Wordstat на вкладке «Топы запросов» за последний месяц. Поэтому в файле нужна колонка «источник».
Из каких листов состоит файл
Как собирать фразы, подробно разобрано в статье как собрать семантическое ядро по шагам. Здесь речь о том, как записать результат.
- «Сырые фразы». Всё, что выгрузили из Wordstat, подсказок, Вебмастера и сервисов конкурентного анализа. Колонки: фраза, источник, широкая частотность. Этот лист не чистят руками, к нему возвращаются, когда нужно что-то найти.
- «Минус-слова». Слова и фразы, по которым строки отсеяли, с причиной: «другой интент», «бренд конкурента», «не наш город». Подробнее про такие списки в статье о минус-словах.
- «Ядро». Только целевые запросы после чистки, у каждого одна строка и одна страница.
- «Карта страниц». Одна строка на один URL: главный запрос, число запросов в кластере, спрос кластера, тип страницы и статус.
- «Методика». Регион, период, дата среза, какие операторы использовали, каким способом группировали.
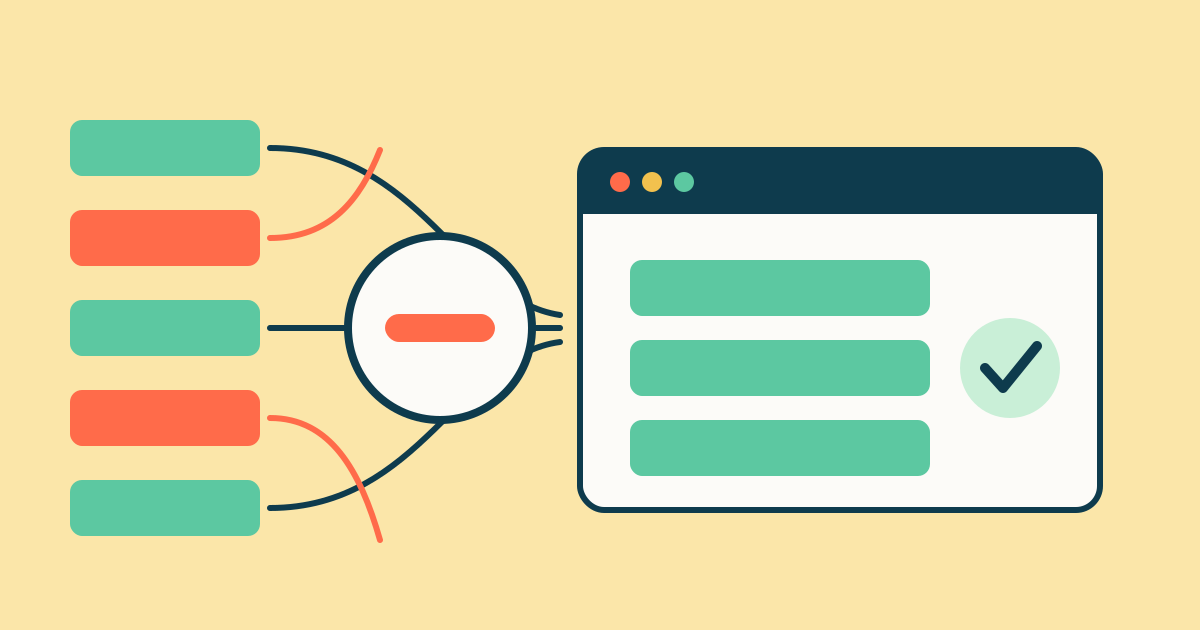
Схема 1. Как листы файла связаны между собой: фразы проходят через фильтр минус-слов, ядро сворачивается в карту страниц, а методика объясняет все цифры.
Какие колонки нужны на листе «Ядро»
| Колонка | Что в ней | Какое решение помогает принять | Обязательна? |
|---|---|---|---|
| Запрос | Фраза в том виде, как её ищут | Основа для всех остальных колонок | да |
| Широкая частотность | Число без операторов | Оценить объём хвоста вокруг фразы | нет |
| Точная частотность | Число с операторами, например "!ремонт !велосипедов" | Считать спрос кластера и выбирать приоритеты | да |
| Интент | Коммерческий, информационный, смешанный | Решить, нужна категория, услуга или статья | да |
| Кластер | Название группы запросов | Свести несколько фраз на одну страницу | да |
| URL | Существующий адрес или пометка «новая» | Превратить список в план работ | да |
| Приоритет | Высокий, средний, низкий | Решить, что делать в первый месяц | нет |
| Источник и дата | Wordstat, Вебмастер, сервис; дата среза | Не сравнивать несравнимые цифры | нет, но лучше завести |
Точную частотность берут в Wordstat с операторами. По справке Wordstat, кавычки фиксируют количество слов, а восклицательный знак фиксирует форму слова. Вместе они дают число запросов ровно по этой фразе. Подробно про разницу цифр в статье о частотности запросов.
Колонка «источник» нужна потому, что сервисы считают по-разному. Wordstat на вкладке «Топы запросов» показывает данные за последний месяц, а инструмент Вебмастера «Подбор поисковых запросов и анализ рынка» по его справке даёт спрос, клики и конкурентность как среднемесячные значения за прошлый год. Цифры из двух источников в одной колонке без пометки сравнивать нельзя.
Как выглядит лист «Ядро» на условной нише
| Запрос | Широкая | Точная | Интент | Кластер | URL | Приоритет |
|---|---|---|---|---|---|---|
| ремонт велосипедов | 6 400 | 1 450 | коммерческий | Ремонт велосипедов | / | высокий |
| ремонт велосипедов рядом | 2 100 | 620 | коммерческий | Ремонт велосипедов | / | высокий |
| веломастерская | 1 800 | 540 | коммерческий | Ремонт велосипедов | / | высокий |
| обслуживание велосипеда цена | 900 | 210 | коммерческий | ТО велосипеда | /to/ | средний |
| то велосипеда | 700 | 160 | коммерческий | ТО велосипеда | /to/ | средний |
| замена цепи на велосипеде | 1 300 | 280 | смешанный | Замена цепи | /uslugi/zamena-cepi/ | средний |
| как поменять цепь на велосипеде | 2 400 | 390 | информационный | Замена цепи своими руками | /blog/kak-zamenit-cep/ | низкий |
| настройка переключателя скоростей | 1 600 | 310 | информационный | Настройка переключателя | /blog/nastrojka-pereklyuchatelya/ | низкий |
| прокачка гидравлических тормозов | 800 | 170 | коммерческий | Тормоза | /uslugi/tormoza/ | средний |
| хранение велосипеда зимой | 1 100 | 260 | смешанный | Хранение | новая: /hranenie/ | высокий |
Что в этой таблице стоит заметить:
- «Замена цепи» разделена на две страницы. Фразу с «как поменять» ищут те, кто хочет сделать сам, поэтому она ведёт в блог, а «замена цепи на велосипеде» на страницу услуги. Такое деление подтверждают по выдаче: если в топе по двум фразам разные страницы, это разные кластеры. Метод описан в статье про кластеризацию семантического ядра.
- Широкие числа не складываются. Широкая частотность «ремонт велосипедов» уже включает «ремонт велосипедов рядом», поэтому сумма 6 400 + 2 100 считает одни запросы дважды.
- «Хранение» помечено как новая страница с высоким приоритетом. У мастерской такой услуги на сайте нет, но спрос есть. Здесь ядро даёт задачу бизнесу, а не только SEO.
- «Велосипед купить» в ядро не попал. Это другой интент, строка ушла на лист «Минус-слова» с причиной «продажа, не наша услуга».
Как выглядит карта страниц
| URL | Главный запрос | Запросов в кластере | Спрос кластера (точн.) | Тип | Статус |
|---|---|---|---|---|---|
| / | ремонт велосипедов | 3 | 2 610 | главная, услуги | оптимизировать |
| /blog/kak-zamenit-cep/ | как поменять цепь на велосипеде | 1 | 390 | статья | написать |
| /to/ | обслуживание велосипеда цена | 2 | 370 | услуга | оптимизировать |
| /blog/nastrojka-pereklyuchatelya/ | настройка переключателя скоростей | 1 | 310 | статья | написать |
| /uslugi/zamena-cepi/ | замена цепи на велосипеде | 1 | 280 | услуга | создать |
| /hranenie/ | хранение велосипеда зимой | 1 | 260 | услуга | создать |
| /uslugi/tormoza/ | прокачка гидравлических тормозов | 1 | 170 | услуга | оптимизировать |
В настоящем файле в кластерах десятки фраз, а не 1–3. Но принцип тот же: главный запрос страницы это фраза с наибольшей точной частотой и интентом, который совпадает с типом страницы. Как из такой карты вырастает структура разделов, разобрано в статье про структуру сайта, а как превратить статьи из карты в график публикаций, в статье про контент-план.
Как выглядит настоящая выгрузка: кусок семантики блога
| Главный запрос темы | Широкая | Точная | Спрос темы | Уровень | URL |
|---|---|---|---|---|---|
| ключевые слова | 282 350 | 2 008 | 4 442 | A | /klyuchevye-slova/ |
| поисковые запросы | 149 345 | 555 | 1 329 | A | пока нет |
| семантическое ядро | 4 176 | 570 | 1 189 | A | /kak-sostavit-pravilno-semanticheskoe-yadro/ |
| что такое ключевые слова в тексте | 5 270 | 579 | 872 | B | /kak-pravilno-pisat-seo-stati/ |
| подобрать ключевые слова | 4 011 | 41 | 547 | B | /kak-podobrat-klyuchevye-slova-dlya-sajta/ |
| коммерческие запросы | 14 524 | 49 | 98 | C | пока нет |
| типы поисковых запросов | 5 978 | 18 | 77 | C | /tipy-poiskovyx-zaprosov/ |
| lsi слова | 192 | 30 | 71 | C | /lsi-klyuchi/ |
| сервис подбора ключевых слов | 110 | 39 | 39 | D | пока нет |
| анализ ключевых слов | 3 787 | 5 | 35 | D | пока нет |
| информационные запросы | 10 230 | 15 | 24 | D | пока нет |
| этот материал (образец файла) | 99 | 18 | 18 | D | /primer-semanticheskogo-yadra/ |
| операторы поисковых запросов | 1 845 | 17 | 17 | D | /operatory-poiska/ |
| ключевые слова для объявлений | 340 | 5 | 5 | D | пока нет |
| минус слова что это | 3 147 | 2 | 2 | D | /minus-slova/ |
Чем этот файл отличается от учебного:
- Тема, а не запрос. Строка здесь это тема статьи. «Спрос темы» суммирует точные частоты всех фраз группы, поэтому у «ключевых слов» он 4 442 при точной частоте главного запроса 2 008. Остальное дают «что такое ключевые слова», «seo ключи» и ещё 7 фраз той же группы.
- Уровни спроса. A от 1 000 запросов в месяц, B от 200 до 999, C от 50 до 199, D меньше 50. Уровень отвечает на вопрос «что писать первым», а не «писать ли вообще».
- «Пока нет» не значит «не нужно». Темы без страницы ждут своей очереди в плане или будут закрыты разделом в соседней статье. Например, информационные запросы как тип уже объяснены в статье про типы поисковых запросов.
Наши данные: как распределён спрос в реальном кластере
Методика: из файла плана блога (477 тем, Wordstat через xmlstock, Россия, 30 дней, срез 14.11.2026) взяли кластер «Ключевые слова и семантика», посчитали долю каждого уровня в спросе и отношение точной частоты главного запроса к широкой.
| Уровень | Тем | Спрос | Доля спроса кластера |
|---|---|---|---|
| A (1000+) | 3 | 6 960 | 79,4% |
| B (200–999) | 2 | 1 419 | 16,2% |
| C (50–199) | 3 | 246 | 2,8% |
| D (<50) | 7 | 140 | 1,6% |
| Итого | 15 | 8 765 | 100% |
Три вывода, которые пригодятся при чтении любого чужого файла:
- Короткие запросы сильнее всего раздуты. У «ключевые слова» точная частота 0,7% от широкой, у «поисковые запросы» 0,4%. У длинной фразы про образец ядра доля выше: 18 из 99, то есть 18,2%. Если в файле нет точной частотности, приоритеты в нём почти наверняка неверные.
- Половина тем приносит меньше 2% спроса. Семь тем уровня D вместе дают 140 запросов в месяц. Их держат в ядре ради полноты и внутренних ссылок, а не ради трафика.
- Одна тема может закрыть целый кластер. На «ключевые слова» приходится 50,7% спроса кластера. Если такая страница слабая, кластер не работает, сколько бы нишевых статей вокруг ни было.
Как проверить чужой файл за 10 минут
- Отфильтруйте пустые URL. Если их больше половины, вам продали список фраз, а не ядро.
- Найдите дубли запросов. Одна фраза на двух адресах означает, что страницы будут конкурировать между собой.
- Сравните две колонки частотности. Если «точная» почти равна «широкой» у коротких запросов, скорее всего, операторы не использовали.
- Посмотрите лист «Методика». Без региона и даты среза цифрам нельзя доверять: спрос по Москве и по России может отличаться в разы.
- Проверьте 3–5 кластеров по выдаче. Введите две фразы из одного кластера в Яндекс. Если в топ-10 почти нет общих адресов, группировку стоит пересмотреть.
Ещё один признак плохого файла: десятки почти одинаковых страниц под каждый город или вариант формулировки. В правилах Google в отношении спама это прямо описано как злоупотребление дорвеями, в том числе страницы для разных городов, которые ведут на одно и то же.
Кому такой файл не нужен
- Сайт-визитка на 3–5 страниц. Достаточно списка из 20–30 фраз с точной частотностью и пометкой, на какую страницу каждая. Отдельные листы методики и минус-слов тут лишние.
- Новостной сайт. Спрос на свежие события появляется после публикации, Wordstat покажет его только задним числом.
- Проект, где запросы уже известны по Вебмастеру и Search Console. Если сайт старый и трафик есть, начните с реальных запросов, по которым он показывается, а ядро стройте только под новые разделы.
- Тем, кто ждёт от файла гарантии позиций. Ядро отвечает на вопрос «какие страницы нужны», а не «как попасть в топ». Google в руководстве для начинающих советует думать, какими словами люди будут искать ваш контент, но тот же документ называет избыточное повторение ключевых слов нарушением правил.
Частые вопросы
Как должно выглядеть ядро в Excel?
Как таблица, где одна строка это один запрос, а колонки фиксируют точную частотность, интент, кластер и адрес страницы. Сырые фразы, минус-слова и карту страниц удобнее держать на отдельных листах того же файла.
Какие колонки обязательны?
Запрос, точная частотность, интент, кластер и URL. Широкая частотность, приоритет, статус и источник полезны, но без пяти основных колонок файл не даёт решений.
Сколько запросов должно быть в ядре?
Нормы нет. Для мастерской из нашего условного образца хватит 50–150 целевых фраз, у интернет-магазина их тысячи. Ориентир не число строк, а то, что у каждого товарного раздела и каждой услуги есть свой кластер.
Можно ли взять чужое ядро как шаблон?
Структуру листов и колонок можно. Сами фразы и цифры нет: у конкурента другой регион, другой ассортимент и другая дата среза. Частотности всегда снимайте заново в Wordstat.
Чем ядро отличается от карты страниц?
Ядро хранит все запросы, а карта страниц сворачивает их до одной строки на URL с главным запросом и спросом кластера. По карте ставят задачи на тексты, по ядру проверяют, что ни один запрос не потерян.
Источники
- Справка Wordstat: операторы кавычки и восклицательный знак
- Справка Wordstat: вкладки нового интерфейса и периоды данных
- Справка Яндекс Директа: символы и операторы в ключевых фразах
- Справка Яндекс Вебмастера: подбор поисковых запросов и анализ рынка
- Google: руководство по поисковой оптимизации для начинающих
- Google: правила в отношении спама, раздел о дорвеях