BERT (Bidirectional Encoder Representations from Transformers) это языковая модель, которую исследователи Google описали в октябре 2018 года (arXiv). Её главное свойство: она понимает слово с учётом всех соседних слов, и слева, и справа. Для поиска это значит, что предлоги, отрицания и порядок слов перестали теряться. 25 октября 2019 года Google объявил, что модель помогает понимать каждый десятый англоязычный запрос в США, и назвал это крупнейшим шагом вперёд за пять лет (блог Google).
Яндекс прошёл тот же путь своим маршрутом. В 2016 году «Палех» начал сравнивать смысл запроса и заголовка, в 2017-м «Королёв» стал сравнивать с текстом страницы, а в ноябре 2020 года Яндекс объявил, что перевёл Поиск на собственные трансформеры YATI, и назвал это самым важным событием в Поиске за 10 лет (блог Яндекса).
Что умеет модель и почему её назвали прорывом
Чтобы понять разницу, вспомните word2vec (2013): там у слова «ключ» один вектор, будь то ключ от двери, родник или скрипичный ключ. Подробнее об этом поколении в статье про эмбеддинги. Модель Google 2018 года строит вектор слова заново в каждой фразе. «Ключ» в «ключ от квартиры» и в «бьёт ключом» получит разные представления.
Как этого добились:
- Архитектура трансформер. Её описали в статье «Attention Is All You Need» в июне 2017 года (arXiv). Механизм внимания позволяет каждому слову «посмотреть» на все остальные слова фразы и решить, какие из них важны для его смысла.
- Маскирование. При обучении модель скрывает 15% токенов текста и учится их угадывать по окружению. Чтобы угадать пропуск в середине предложения, нужно смотреть и влево, и вправо: отсюда двунаправленность.
- Масштаб. Две версии, 110 и 340 млн параметров, словарь WordPiece на 30 000 токенов, 3,3 млрд слов обучающего текста.
Результат в статье: новые лучшие показатели на 11 задачах обработки языка и рост общего теста GLUE до 80,5%, на 7,7 пункта. Главное практическое отличие от ChatGPT и других генеративных моделей: это кодировщик. Он не пишет текст, а превращает его в векторы, которые дальше используют для классификации, поиска и ранжирования. Как устроены генеративные модели, разобрано в статье «что такое LLM».
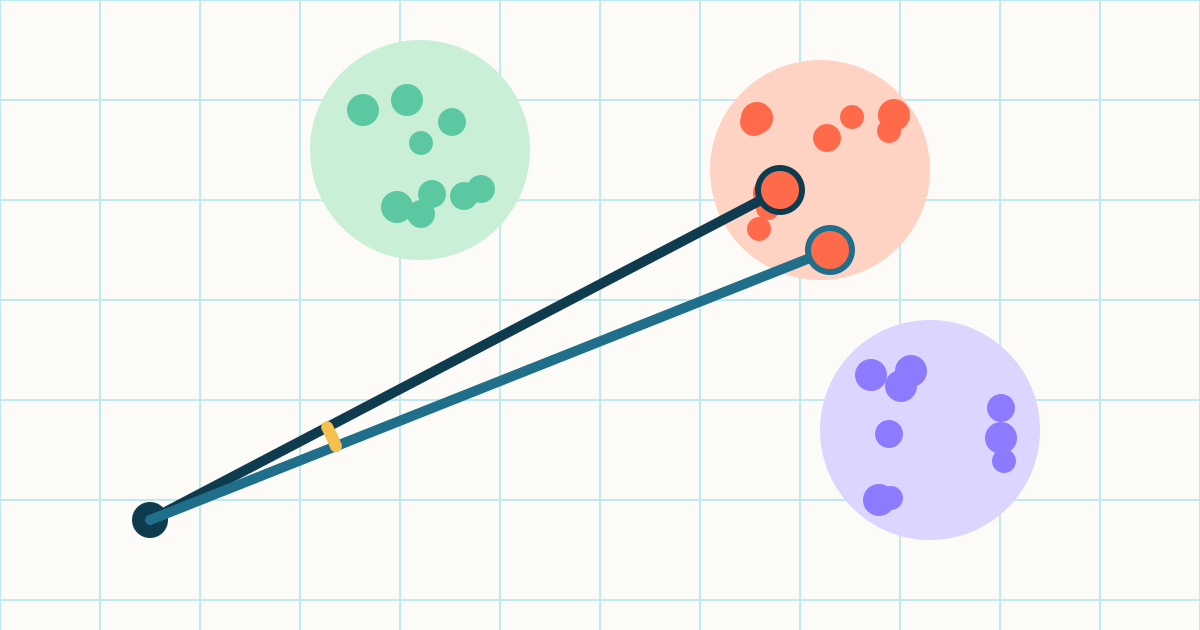
Схема 1. Старый подход видит набор слов, кодировщик видит связи между ними, включая предлоги.
Что изменилось в выдаче Google
Примеры из поста Пандю Наяка, вице-президента Google по поиску:
- «2019 brazil traveler to usa need a visa». Раньше поиск выдавал страницы о поездках граждан США в Бразилию. Новая модель поняла, что важен предлог «to»: бразилец едет в США.
- «do estheticians stand a lot at work». Старая система сопоставляла «stand» со «stand-alone», новая поняла, что речь о физической нагрузке на работе.
- «parking on a hill with no curb». Раньше система придавала вес слову «curb» и игнорировала «no».
Модель также улучшила блоки с ответом в двух десятках стран, где они были, с заметным ростом на корейском, хинди и португальском. Для её работы Google впервые использовал в выдаче облачные процессоры Cloud TPU. 9 декабря 2019 года через аккаунт SearchLiaison компания сообщила о запуске на более чем 70 языках (Search Engine Land), а 15 октября 2020 года написала, что модель используется почти в каждом англоязычном запросе (блог Google).
Пост честно признаёт пределы: на запрос «what state is south of Nebraska» модель предложила населённый пункт South Nebraska. Поиск, как пишет Google, «не решённая задача».
| Система Google | Год | Что делает | Почему важно для сайта |
|---|---|---|---|
| RankBrain | 2015 | Первая система глубокого обучения в поиске: связывает слова с понятиями | Страница находится по смежным формулировкам |
| Neural matching | 2018 | Находит документы по понятиям, а не только по словам | Отбор кандидатов перестаёт зависеть от точного вхождения |
| BERT | 2019 | Понимает сочетания слов, включая предлоги; работает и в ранжировании, и в отборе документов | Важен смысл фразы целиком, а не набор ключей |
| MUM | 2021 | Обучена на 75 языках, в 1000 раз мощнее BERT по оценке Google; для общего ранжирования на февраль 2022 года не применялась | Показывает направление, но не влияет на обычную выдачу напрямую |
Данные: How AI powers great search results, Google, февраль 2022.
Как Яндекс пришёл к трансформерам
Схема 2. Две параллельные линии: исследования и внедрения в Google и в Яндексе.
Палех, 2 ноября 2016. Нейросеть переводит запрос и заголовок страницы в семантические векторы из 300 чисел и сравнивает их. Цель: редкие запросы длинного хвоста, по которым мало статистики; таких, по данным Яндекса, около ста миллионов в день. Вектор стал одним из более чем тысячи факторов, а решал, как его учитывать, Матрикснет (блог Яндекса).
Королёв, 22 августа 2017. Сравнивает уже вектор всего текста страницы, а не только заголовка. Векторы страниц считаются заранее при индексации, иначе это слишком дорого. Смысловой анализ применяется примерно к 200 000 документов вместо 150 у Палеха (блог Яндекса).
YATI, 2020. Название расшифровывается как Yet Another Transformer with Improvements. Модель сопоставляет смысл запросов и документов, как Палех и Королёв, но за счёт трансформеров справляется с этим намного лучше, учитывает порядок слов и контекст, работает и с короткими, и с длинными текстами. В посте 25 ноября 2020 года Яндекс пишет, что модель прошлого поколения обучалась на одном ускорителе за час, а большой трансформер на том же железе учился бы около десяти лет; для внедрения пришлось объединять ускорители в кластеры (блог Яндекса). В 2024 году в обзоре десяти лет нейросетей в Поиске Яндекс назвал прирост от YATI рекордным со времён Матрикснета (2009) (Хабр, блог Яндекса).
Как эти сигналы встраиваются в общую формулу, мы разобрали в статье про ранжирование.
Можно ли подготовить сайт к этим алгоритмам
28 октября 2019 года Дэнни Салливан из Google написал, что под модель нечего оптимизировать и нечего переосмысливать, а цель поиска по-прежнему вознаграждать хороший контент (Search Engine Roundtable). То же верно для YATI: Яндекс не публиковал рекомендаций «под YATI», его общие требования к качеству описаны в справке Вебмастера.
Практические выводы (наши, по механике моделей):
- Ломаный русский из ключей вредит. «Купить диван Москва недорого» в тексте модель читает как бессвязную фразу. Естественное предложение с теми же словами понятнее и человеку, и модели. Подробнее в статье о ключевых словах.
- Служебные слова решают. «Билет из Москвы в Казань» и «из Казани в Москву» для старого поиска почти одно и то же, для трансформера это разные запросы. Если страница про одно направление, формулируйте это явно.
- Длинный хвост стал доступнее. Модель лучше понимает длинные вопросы обычным языком, поэтому страница с точным ответом на узкий вопрос может обойти общую. Это аргумент в пользу разбора типов запросов и отдельных страниц под разные интенты.
- Отвечайте рядом с вопросом. Модель оценивает соответствие фрагмента запросу. Прямой ответ в первых предложениях раздела помогает и в обычной выдаче, и в нулевой позиции.
Как это связано с нейроответами
В оригинальной статье о RAG (2020) поиск документов построен на DPR, где вопрос и документ кодируют две модели на базе BERT (arXiv). Та же схема, «кодировщик ищет, генератор пишет», лежит в основе ИИ-ответов со ссылками. Подробно этот конвейер описан в статье про RAG, а как он устроен в Яндексе, в материале об Алисе AI в Поиске.
Наши данные: что ищут об этих моделях
Методика: Яндекс Wordstat, Россия, 30 дней, срез 14.11.2026, точные частоты; спрос темы это сумма точных частот запросов группы.
| Показатель | Значение | Вывод |
|---|---|---|
| Спрос темы (3 запроса) | 318 | Узкая тема для профессионалов |
| Главный запрос в кавычках | 258 (81% темы) | Ищут одно слово, уточнения «модель» и «нейросеть» дают остальные 19% |
| Главный запрос, широкая частота | 8 102 | В 31 раз больше точной: латинское «bert» совпадает с именами, брендами и названиями чужих моделей |
| Запросы про YATI, Палех, Королёв | В собранной семантике (около 7 тыс. фраз с точной частотой) не встретились | Названия алгоритмов Яндекса массово не ищут, хотя влияют они на каждый запрос |
| Для сравнения: эмбеддинги / LLM / генерация с поиском | 74 499 / 11 001 / 5 402 | Интерес сместился к терминам эпохи нейроответов |
Почему широкая частота коротких латинских слов почти всегда завышена, мы объясняем в гиде по Вордстату.
Кому это не нужно
- Если сайт продаёт по брендовым и товарным запросам. Для «iPhone 16 128 ГБ купить» понимание предлогов почти ничего не меняет, решают ассортимент, цена и коммерческие факторы.
- Если вам предлагают «аудит под BERT» или «текст под YATI». Таких метрик снаружи не существует: Google в 2019 году прямо сказал, что оптимизировать нечего.
- Если нужна модель для своего проекта. Эта статья про поиск. Выбор кодировщика для своей системы это инженерная задача, начать её стоит с разбора векторного поиска.
Частые вопросы
Что это за модель простыми словами?
Это нейросеть Google, которая читает текст и превращает каждое слово в набор чисел с учётом всех соседних слов. Благодаря этому поиск понимает, что «виза в США для бразильца» и «виза в Бразилию для американца» это разные вопросы.
Что такое YATI в Яндексе?
Это нейросеть-трансформер, на которую Яндекс перевёл Поиск в 2020 году. Название означает Yet Another Transformer with Improvements. Она сопоставляет смысл запроса и документа, как раньше Палех и Королёв, но заметно точнее.
Эта нейросеть похожа на ChatGPT?
Обе построены на трансформерах, но задачи разные. Модель Google 2018 года это кодировщик: она понимает и представляет текст в виде векторов. ChatGPT генерирует текст слово за словом. В поиске первая помогает находить и ранжировать, вторая писать ответ.
Как оптимизировать сайт под алгоритмы понимания запросов?
Специальной оптимизации нет, это прямо сказал Google. Пишите естественным языком, отвечайте на конкретный вопрос в начале раздела, не склеивайте ключевые фразы и не смешивайте разные интенты на одной странице.
Используется ли эта модель в поиске сейчас?
По данным Google на февраль 2022 года, она участвует почти в каждом англоязычном запросе, и в ранжировании, и в отборе документов. Более свежей официальной оценки её доли мы у Google не нашли.
Источники
- Devlin et al. BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding, arXiv, 2018
- Google: Understanding searches better than ever before, Pandu Nayak, 25 октября 2019
- Google: How AI powers great search results, февраль 2022
- Google: Search On 2020, 15 октября 2020
- Блог Яндекса: YaC 2020, что нового (YATI)
- Блог Яндекса: алгоритм «Палех», 2016
- Блог Яндекса: алгоритм «Королёв», 2017
- Хабр, блог Яндекса: 10 лет эволюции нейросетей в Поиске, 2024
- Vaswani et al. Attention Is All You Need, arXiv, 2017
- Search Engine Roundtable: Google, There Is Nothing To Optimize For With BERT
- Search Engine Land: запуск в Google Поиске на 70+ языках, декабрь 2019