LLM расшифровывается как Large Language Model, по-русски «большая языковая модель». Это нейросеть с миллиардами параметров, которую обучили на огромном объёме текстов. Её базовое умение звучит скромно: по началу текста предсказать, какой фрагмент слова (токен) пойдёт следующим. Но если повторять это предсказание тысячи раз подряд, получается связный ответ, письмо, код или статья.
Anthropic в своём глоссарии описывает предобучение именно так: модель учат «предсказывать следующее слово с учётом предыдущего контекста» (Glossary, Claude Docs). На этом принципе работают ChatGPT, Claude, Gemini, Алиса AI и ГигаЧат. Ниже разберём, как модель превращает ваш вопрос в ответ, откуда у неё ошибки и почему владельцу сайта это важно понимать.
Что значит «большая» и чем модель отличается от обычной программы
Параметры это числа внутри нейросети, которые подбираются при обучении. У современных моделей их десятки и сотни миллиардов. Например, открытая модель Яндекса Alice AI Foundation LLM, опубликованная 21 сентября 2026 года, содержит около 80 млрд параметров, из которых при обработке каждого токена работают примерно 3 млрд (новость Яндекса). Такая схема называется «смесь экспертов» (Mixture of Experts): модель большая, но для каждого шага включает только нужную часть.
Обучение идёт в несколько этапов:
- Предобучение. Модель читает огромный корпус текстов и учится угадывать продолжение. После этого этапа она знает язык и много фактов, но плохо выполняет просьбы.
- Дообучение (fine-tuning). Модель дополнительно учат на примерах диалогов «вопрос → хороший ответ».
- Обучение с подкреплением на оценках людей (RLHF). Люди сравнивают несколько ответов, и модель учится выбирать те, что оценены выше (статья Anthropic о RLHF, arXiv).
Поэтому «голая» предобученная модель и чат-ассистент это разные вещи. Ассистент это та же модель после дообучения, плюс интерфейс, инструкции и часто подключённый поиск.
Как модель пишет ответ: пошагово
Схема 1. Один шаг генерации. Цикл повторяется для каждого токена ответа.
Шаг 1. Токенизация. Текст делится на токены: это целые слова, части слов, отдельные символы. Сколько символов в одном токене, зависит от модели и языка. Anthropic пишет, что у её прежних моделей токен в среднем соответствовал примерно 3,5 символа английского текста, а новый токенизатор (с Claude 4.7) даёт примерно на 30% больше токенов на тот же текст (Glossary, Claude Docs).
Шаг 2. Векторы. Каждый токен превращается в набор чисел, вектор, который кодирует его смысл. Близкие по значению слова получают близкие векторы. Подробно этот механизм мы разобрали в статье про эмбеддинги.
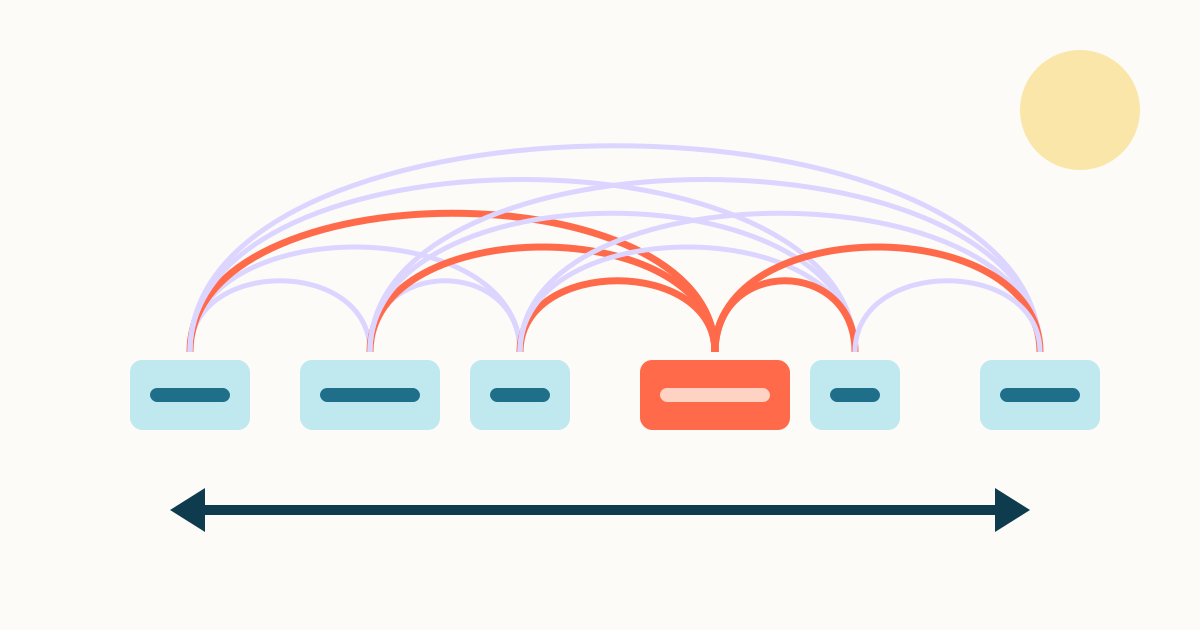
Шаг 3. Внимание. Векторы проходят через десятки слоёв трансформера. Ключевой механизм здесь «внимание» (attention): для каждого токена модель оценивает, какие другие токены контекста важны для его смысла. В фразе «ключ от замка» и «ключ из-под земли» слово «ключ» получит разный смысл именно за счёт внимания к соседям. Архитектуру трансформера предложили исследователи Google в 2017 году в статье «Attention Is All You Need» (arXiv). Та же идея лежит в поисковых моделях, о которых мы писали в материале про BERT и YATI.
Шаг 4. Вероятности. На выходе модель выдаёт оценку для каждого токена из своего словаря: насколько вероятно, что он идёт следующим. Например, после «Столица Франции» у токена « Париж» вероятность будет очень высокой.
Шаг 5. Выбор и повтор. Модель выбирает токен, дописывает его в конец текста и запускает цикл заново. Ответ из 500 слов это сотни таких циклов. Поэтому ответ в чате «печатается» постепенно: вы видите токены по мере генерации.
Что такое температура и почему ответы каждый раз разные
Если всегда брать самый вероятный токен, текст получается предсказуемым и однообразным. Поэтому модели выбирают с долей случайности. По глоссарию Anthropic, высокая температура даёт более «творческие и разнообразные» ответы, низкая более консервативные; при этом даже при температуре 0 результаты API «не будут полностью детерминированными» (Glossary, Claude Docs). Отсюда практическое следствие: один и тот же вопрос в нейропоиске может дать разные ответы и разные ссылки. Справка Яндекс Вебмастера прямо предупреждает об этом и для ответов Алисы AI (Как формируются ответы Алисы AI).
Что такое контекстное окно
Anthropic называет контекстное окно «рабочей памятью» модели и отличает его от данных обучения (Glossary). На 14.11.2026 у всех текущих моделей Claude окно 1 млн токенов, что, по документации, соответствует примерно 555 тыс. слов английского текста (Models overview). У моделей Gemini 4 тоже 1 млн токенов (Gemini models), у флагманских моделей OpenAI 1,05 млн (OpenAI Models).
Какие языковые модели есть сейчас
Названия ниже сверены по официальным страницам разработчиков на 14.11.2026. Линейки обновляются несколько раз в год, поэтому смотрите на семейство, а не на номер версии.
| Семейство | Разработчик | Актуальные модели на 14.11.2026 | Где встречается |
|---|---|---|---|
| GPT | OpenAI (США) | GPT-6.1 Sol, GPT-6.1 Terra, GPT-6 Astra, GPT-6 Luna (OpenAI Models) | ChatGPT, API, сторонние сервисы, в том числе Perplexity |
| Claude | Anthropic (США) | Claude Fable 5.2, Opus 5.5, Sonnet 5.5, Haiku 5.5 (Models overview) | claude.ai, API, облака AWS, Google Cloud, Microsoft |
| Gemini | Google (США) | Gemini 4 Carbon, Gemini 4 Argon, Gemini 4 Hydrogen, линейка Gemini 3.x Flash (Gemini models) | Приложение Gemini, AI Mode в Google Поиске |
| Alice AI LLM | Яндекс (Россия) | Alice AI LLM; открытая Alice AI Foundation LLM, 80 млрд параметров (новость Яндекса) | Алиса AI, ответы в Поиске Яндекса, Yandex Cloud |
| GigaChat | Сбер (Россия) | GigaChat 3.5 Ultra, представлена в июле 2026, выложена в открытый доступ (Sostav, со ссылкой на Сбер) | Ассистент ГигаЧат, API для бизнеса |
Кроме закрытых моделей есть открытые: их веса можно скачать и запустить у себя. Так поступил Яндекс с Alice AI Foundation LLM (лицензия Apache 2.0), Сбер с GigaChat 3.5 Ultra; известные зарубежные семейства открытых моделей это DeepSeek и Qwen. Как выбирать между ними, это тема для отдельного разговора; для SEO важнее другое: какие из них стоят за поисковыми ответами. Это Alice AI LLM в ответах Алисы AI, Gemini в AI Mode и несколько моделей в Perplexity.
Понимает ли модель смысл текста
Самое наглядное исследование на эту тему опубликовала Anthropic 27 марта 2025 года. Исследователи ожидали, что модель пишет стихи слово за словом и подбирает рифму только в конце строки. Оказалось, что модель заранее выбирает слово для рифмы и пишет строку так, чтобы к нему прийти. Ещё одна находка: понятия вроде «маленький» и «противоположность» активируют одни и те же внутренние признаки на английском, французском и китайском, то есть у модели есть общее для языков пространство смыслов (Tracing the thoughts of a large language model).
При этом модель не «знает», где правда. Она выдаёт правдоподобное продолжение. Если в обучающих данных факт встречался редко или противоречиво, модель всё равно ответит гладко.
Почему модель выдумывает факты
Так объясняют галлюцинации исследователи OpenAI и Технологического института Джорджии в работе «Why Language Models Hallucinate» (4 сентября 2025): правдоподобные, но ложные утверждения возникают, потому что схемы обучения и оценки вознаграждают догадку вместо признания неуверенности (arXiv). Отсюда главный способ снизить ошибки: дать модели свежие источники прямо в контекст. Этот подход называется RAG, его мы разобрали в статье «RAG: как нейросети подтягивают данные».
Что из этого следует для сайта
Практические выводы:
- Поисковые ответы опираются на поиск. По справке Яндекс Вебмастера, Алиса AI отправляет уточнённые запросы в Поиск и использует страницы, которые «высоко ранжируются» (справка Вебмастера). Значит, классическое SEO остаётся фундаментом, а не уходит в прошлое. Разницу между обычным поиском и нейропоиском мы разобрали в статье про ИИ-поиск.
- Модель цитирует фрагменты, а не страницы целиком. Чем короче и точнее абзац отвечает на вопрос, тем проще его взять в ответ. Об этом подробнее в материале про GEO-оптимизацию.
- Свежие факты нужно писать с датой и источником. Память модели заканчивается датой обучения. У текущих моделей Claude это июнь 2026 года (Models overview): всё, что случилось позже, модель узнает только из поиска.
- Тексты, написанные моделью, нужно проверять. Модель пишет гладко, но факты, цифры и названия часто требуют сверки. Как мы делаем это в редакции, описано в статье «Как писать статьи для сайта».
| Режим ответа | Откуда факты | Чем платите | Почему важно сайту |
|---|---|---|---|
| Модель без поиска | Память модели на дату обучения | Устаревшие факты, выдуманные детали | На такой ответ сайт повлиять почти не может, ссылок на источники нет |
| Модель с поиском (RAG) | Найденные страницы, переданные в контекст | Время ответа и стоимость поиска | Сайт попадает в ответ, если его страница нашлась и её фрагмент полезен |
| Модель с рассуждением | Память плюс промежуточные шаги, часто плюс поиск | Дольше и дороже обычного ответа | Вопрос часто разбивается на подвопросы, и источником может стать страница, которая точно отвечает на один из них |
Наши данные: что спрашивают о языковых моделях в Яндексе
Методика: Яндекс Wordstat, Россия, 30 дней, срез 14.11.2026. Запросы темы разбиты на четыре группы, спрос группы это сумма точных частот её запросов.
| Группа запросов | Точная частота | Доля темы | Что это значит |
|---|---|---|---|
| «llm», «llm модель», «что такое llm простыми словами» и др. | 10 191 | 92,6% | Большинство хочет определение и расшифровку |
| «как ии пишет тексты», «как работает llm», «как llm генерирует текст» | 502 | 4,6% | Механика интересна узкой аудитории |
| «llm понимает текст так же как человек» и др. | 171 | 1,6% | Вопрос о «понимании» задают редко, но формулируют длинно |
| «llm примеры» и др. | 137 | 1,2% | Списки моделей ищут по названиям, а не через «примеры» |
Для сравнения на тот же срез: тема эмбеддингов собирает 74 499 запросов, тема RAG 5 402. Термин «LLM» ищут вдвое чаще, чем RAG, но в 6,8 раза реже, чем эмбеддинги. Наш вывод для структуры статьи: определение и расшифровку мы дали в первых абзацах, а механику уложили в один раздел со схемой, без длинной теории.
Кому это не нужно
- Владельцу локального бизнеса важнее карточка в картах и отзывы: механика модели мало что меняет в его работе.
- Тем, кому нужен код. Статья не учит обучать или дообучать модели; для этого нужны курсы по машинному обучению и документация конкретной модели.
- Если вы выбираете модель для бизнеса, таблица выше это только ориентир. Цены, лимиты и качество на ваших задачах проверяйте тестами: номера версий меняются несколько раз в год.
Частые вопросы
Как расшифровывается Large Language Model?
Large Language Model, большая языковая модель. Это нейросеть с миллиардами параметров, обученная на больших массивах текста предсказывать следующий токен.
Чем большая языковая модель отличается от нейросети?
LLM это один из видов нейросетей, предназначенный для работы с текстом. Нейросети бывают и другие: для изображений, звука, рекомендаций. Чат-ассистенты вроде ChatGPT, Claude и Алисы AI построены на языковых моделях.
Как языковая модель генерирует текст?
По одному токену. Модель оценивает вероятность каждого возможного следующего токена, выбирает один с учётом температуры, дописывает его и повторяет цикл до конца ответа.
Откуда модель берёт свежие данные?
Из поиска. Сама модель знает только то, что было в обучающих данных до определённой даты. Свежие факты ей передают через подключённый поиск или загруженные документы, этот подход называется RAG.
Можно ли доверять ответам языковой модели?
Проверять нужно всегда, особенно цифры, даты, цены и цитаты. Ответы с указанными источниками проверить проще: откройте ссылку и найдите факт на странице.
Источники
- Vaswani и др., «Attention Is All You Need», arXiv, 2017
- Глоссарий Claude Docs: токены, температура, контекстное окно, предобучение, RLHF
- Обзор моделей Claude: контекстное окно и даты обучения
- Список моделей OpenAI API
- Список моделей Gemini в Google AI Studio
- Новость Яндекса: Alice AI Foundation LLM в открытом доступе (21.09.2026)
- Sostav: Сбер представил GigaChat 3.5 Ultra (06.07.2026)
- Anthropic: Tracing the thoughts of a large language model (27.03.2025)
- Kalai и др., «Why Language Models Hallucinate», arXiv, 2025
- Bai и др., обучение ассистента с RLHF, arXiv, 2022
- Справка Яндекс Вебмастера: как формируются ответы Алисы AI