Если контент страницы появляется только после выполнения JavaScript, поисковику нужно сделать лишний шаг: не просто скачать HTML, а выполнить скрипты и дождаться результата. Google делает это всегда, но через отдельную очередь: страница сначала сканируется, потом ждёт рендеринга в безголовом Chromium и только после этого индексируется. Робот Яндекса выполняет JavaScript на своё усмотрение, а владелец сайта может это переопределить в Вебмастере. В обоих случаях самый надёжный вариант для поиска: отдавать основной контент, ссылки и мета-теги уже в HTML-ответе сервера (SSR, статическая генерация или пререндеринг), а JavaScript оставить для интерактивности.
Коротко
- Google обрабатывает JS-страницы в три фазы: сканирование, рендеринг и индексирование. В очереди на рендеринг страница может провести несколько секунд «или дольше».
- Если в исходном HTML стоит
noindex, Google может вообще не выполнять JavaScript. Убратьnoindexскриптом не получится. - Googlebot сканирует первые 2 МБ каждого файла в несжатом виде, и каждый JS и CSS файл загружается отдельно с тем же лимитом.
- В Яндекс Вебмастере есть раздел «Рендеринг страниц JavaScript», по умолчанию стоит «На усмотрение робота Яндекса». При SSR Яндекс советует рендеринг запретить.
- Динамический рендеринг Google называет обходным решением и не рекомендует, вместо него предлагает SSR, статический рендеринг или гидрацию.
Как Googlebot обрабатывает страницу на JavaScript
Схема 1. Готовый HTML индексируется по короткому пути, клиентский рендеринг добавляет очередь и риск потерь.
Детали, которые важны на практике:
- Перед загрузкой Googlebot проверяет robots.txt. Если закрыты файлы скриптов или API, из которого страница берёт данные, после рендеринга получится пустой шаблон.
- Рендеринг идёт в «вечнозелёном» Chromium, то есть в свежей версии браузера. Современный синтаксис поддерживается, но для критичных API Google советует проверку возможностей и запасной вариант.
- Лимит размера. Googlebot сканирует первые 2 МБ HTML или другого поддерживаемого файла, лимит считается по несжатым данным. Каждый ресурс, на который ссылается HTML, включая CSS и JavaScript, загружается отдельно с тем же ограничением. Огромный бандл, который не уместился, может не выполниться целиком.
- Состояние не сохраняется. Local Storage, Session Storage и cookies очищаются между загрузками страниц. Если контент зависит от того, что сохранено в браузере, робот его не увидит.
- Разрешения не выдаются. Googlebot отклоняет запросы на доступ к камере, геолокации и другим функциям, требующим согласия пользователя.
- Только HTTP. WebSocket и WebRTC Googlebot не поддерживает, данные должны загружаться обычными HTTP-запросами.
- Кеш агрессивный. Google может игнорировать заголовки кеширования и использовать старые JS и CSS. Решение: хеш содержимого в имени файла (
app.3f9a1c.js), чтобы новая версия получала новый адрес.
Что делает с JavaScript робот Яндекса
В интерфейсе три варианта: «Рекомендую рендерить» (робот учтёт пожелание, но решит сам), «На усмотрение робота Яндекса» и «Не рендерить» (для сайтов с SSR или пререндерингом). Там же можно проверить, как страница выглядит с JS и без него, для мобильных и десктопа.
Раздел помечен как бета-версия. Кроме самой настройки, справка описывает объект window.YandexRotorSettings для страниц, где контент подгружается с задержкой. Его нужно определить до события DOMContentLoaded:
WaiterEnabled: включает проверки готовностиIsLoadedиIsError;IsLoaded: признак или функция, по которой робот понимает, что контент загрузился;IsError: еслиtrue, загрузка считается неудачной, и робот пропускает страницу;FailOnTimeout: еслиtrue, страница не попадёт в базу робота по истечении тайм-аута; еслиfalse, проиндексируется то, что успело загрузиться;NoJsRedirectsToMain: нужен, если сайт вызываетwindow.history.back(), иначе робот может принять это за переход на главную.
Старые схемы для AJAX-сайтов больше не работают. Мета-тег fragment (схема _escaped_fragment_) робот Яндекса игнорирует и индексирует исходную страницу, а от адресов с #! справка рекомендует отказаться: убрать # из ссылок и Sitemap, перейти на History API и поставить 301 со старых адресов.
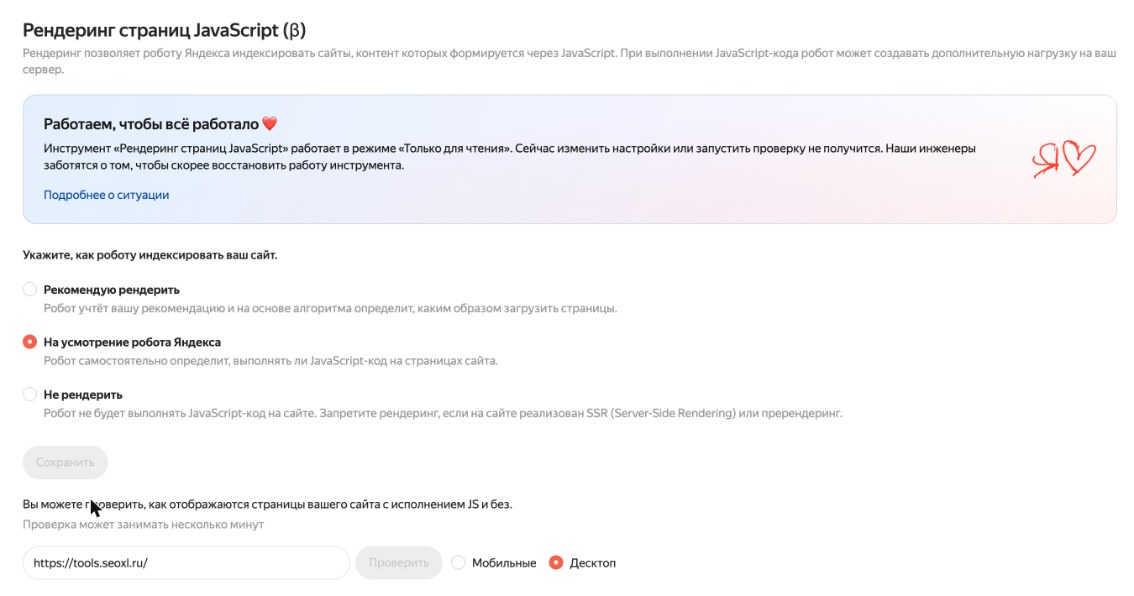
«Индексирование» → «Рендеринг страниц JavaScript» на примере tools.seoxl.ru, 14.11.2026. Выбран вариант по умолчанию. Ниже поле, где можно сравнить страницу с исполнением JS и без него.
SSR, SSG, CSR и гидрация: что выбрать для поиска
Термины в версии web.dev:
- CSR: браузер получает почти пустой HTML и строит страницу JavaScript-кодом, включая загрузку данных и маршрутизацию.
- SSR: сервер собирает HTML на каждый запрос и отдаёт его готовым.
- Статический рендеринг (SSG): HTML для каждого адреса генерируется заранее, при сборке.
- Пререндеринг: клиентское приложение запускается при сборке, и его начальное состояние сохраняется как статический HTML.
- Гидрация: скрипты на клиенте подключают интерактивность к уже отрисованному сервером HTML.
| Что | Когда подходит | Чем платите | Почему важно |
|---|---|---|---|
| CSR (только браузер) | Кабинеты, панели, всё, что за логином | Контент виден роботу только после рендеринга, Яндекс может его не выполнить | Риск, что в индекс попадёт пустой шаблон |
| SSR | Каталоги, карточки, новости: часто меняющиеся данные | Нагрузка на сервер, сложнее инфраструктура | Робот получает контент и ссылки в первом ответе |
| SSG и пререндеринг | Блоги, документация, лендинги | Пересборка при каждом изменении | Самый быстрый ответ, нечему ломаться при сканировании |
| Гидрация (SSR или SSG + JS) | Интерактивные публичные страницы | Двойная работа: HTML и бандл, риск расхождения разметки | Google прямо называет её среди рекомендуемых вариантов |
| Динамический рендеринг (HTML только для ботов) | Временная мера для старого SPA | Две версии сайта, нужна отдельная инфраструктура | Google: обходное решение, не рекомендуется |
Если вы только выбираете платформу, сравнение движков и конструкторов есть в статье на каком движке делать сайт.
Где сайты на JavaScript теряют страницы
Ссылки. Google находит ссылки только в элементах <a> с атрибутом href. Вариант <a href="/catalog/shoes" onclick="..."> сканируется. Варианты <a onclick="goto(...)">, <a routerLink="..."> без href и <a href="javascript:..."> Google не рекомендует. Как связывать страницы между собой, в статье про перелинковку.
Адреса. Для маршрутизации используйте History API. Фрагменты после # Googlebot надёжно не разбирает, а Яндекс прямо просит не использовать их в адресах ссылок.
Статус ответа. В SPA все адреса часто отдают 200, а «страница не найдена» рисуется скриптом. Для поиска это мягкая 404. Google предлагает два выхода: редирект скриптом на адрес, который сервер отдаёт с кодом 404, или noindex в мета-теге robots на странице ошибки. Подробнее в статье про ошибку 404.
noindex. Если страница должна индексироваться, не ставьте noindex в исходный HTML в расчёте убрать его скриптом: увидев этот тег, Google может пропустить рендеринг.
Canonical. Google пишет, что лучше задавать canonical в HTML. Если без JavaScript никак, скрипт должен ставить то же значение, что в исходном коде, и тег на странице должен быть один. Как выбирать канонический адрес, в статье про canonical.
Title и description. Их можно задавать и менять JavaScript-кодом, Google это поддерживает. Но для Яндекса безопаснее отдавать их в HTML, потому что рендеринг у него не гарантирован. Правила составления в статье про мета-теги.
Контент после действия. Всё, что появляется по клику, наведению или прокрутке, робот может не увидеть: он не кликает. Ленивая загрузка картинок допустима, если сделана по правилам Google для lazy-loading.
Как проверить, что видит робот
- Исходный код. Откройте
view-source:или запросите страницу черезcurl. Если в ответе нет основного текста, ссылок меню и title, сайт полностью зависит от рендеринга. - Google. Проверка URL в Search Console или тест расширенных результатов показывают загруженные ресурсы, вывод консоли и отрисованный DOM. После исправлений проверьте ещё раз.
- Яндекс. В Вебмастере раздел Индексирование → Проверка страницы показывает версию в базе (кнопка «Подробнее»), а раздел «Рендеринг страниц JavaScript» позволяет сравнить, какой контент доступен с выполнением JS и без него.
- robots.txt. Убедитесь, что файлы скриптов, стилей и адреса API не закрыты. Как это проверить, в статье про robots.txt.
Наши данные: почему про это почти не спрашивают
Методика. Ядро блога MoreSEO: 477 тем, отобранных из вложенных фраз Wordstat (Россия, 30 дней, срез 14.11.2026). В названиях тем и всех запросах групп мы искали слова «javascript», «js», «рендеринг», «spa», «ssr», «react», «vue», «ajax».
| Что смотрели | Тем | Спрос, точн./мес |
|---|---|---|
| Темы про рендеринг JavaScript | 0 | 0 |
| Кластер «Индексация» | 6 | 505 |
| Кластер «Техническое SEO» | 42 | 23 073 |
| Всё ядро | 477 | 1 407 170 |
В ядре нет ни одной темы и ни одного запроса с этими словами: после отбора по точной частотности они не набрали спроса. Это не значит, что проблемы нет. Её формулируют по симптомам: «сайт не индексируется», «Яндекс не видит текст», а такие запросы уходят в кластеры индексации и технического SEO. Поэтому статья написана как справочная: на неё удобно ссылаться из материалов про индексацию и поисковых роботов, когда причина оказывается в скриптах.
Сравнение того, что документируют сами поисковики:
| Вопрос | Яндекс | |
|---|---|---|
| Выполняет ли JS | Да, всегда через очередь рендеринга | На усмотрение робота или по настройке в Вебмастере |
| Управление владельцем | Нет отдельной настройки | Раздел «Рендеринг страниц JavaScript» (бета) |
| Ожидание медленного контента | Не описано | Объект YandexRotorSettings |
| Адреса с # | Не использовать, нужен History API | Не использовать, `_escaped_fragment_` игнорируется |
| Что советует | SSR, статический рендеринг или гидрация | При SSR или пререндеринге запретить рендеринг |
Кому это не нужно
- Классические CMS. Как настроить SEO на популярных движках, есть в статьях про WordPress, Битрикс и Тильду.
- Страницы за авторизацией. Личному кабинету индексация не нужна, CSR там нормален.
- Небольшой виджет на JS. Калькулятор или карта на странице с текстом не мешают индексации, если текст есть в HTML.
Частые вопросы
Индексирует ли Google сайты на React и Vue?
Да, Google выполняет JavaScript в актуальной версии Chromium. Но индексирование идёт после очереди на рендеринг, а ошибки в ссылках, статусах и noindex никуда не деваются. Для публичных страниц надёжнее SSR или статическая генерация.
Видит ли Яндекс контент, который выводится JavaScript?
Может видеть: робот выполняет JavaScript на своё усмотрение или по настройке в разделе «Рендеринг страниц JavaScript» Вебмастера. Гарантий нет, поэтому важный текст, ссылки и мета-теги лучше отдавать в HTML.
Нужен ли динамический рендеринг?
Google называет его обходным решением и не рекомендует. Вместо него используйте серверный рендеринг, статический рендеринг или гидрацию.
Как SPA отдавать ошибку 404?
Либо перенаправлять скриптом на адрес, который сервер отдаёт с кодом 404, либо добавлять на страницу ошибки мета-тег robots со значением noindex.
Можно ли менять title через JavaScript?
Google это поддерживает. Для Яндекса надёжнее, чтобы title и description были уже в HTML-ответе сервера.
Источники
- Google: основы SEO для сайтов на JavaScript, три фазы обработки
- Google: как исправить проблемы с JavaScript в поиске
- Google: динамический рендеринг как обходное решение
- Google: сканируемые ссылки
- Google: Googlebot и лимит размера файла
- Яндекс Вебмастер: индексирование страниц с JavaScript
- Яндекс Вебмастер: индексирование AJAX-сайтов
- Яндекс Вебмастер: как поиск видит страницы сайта
- web.dev: рендеринг в вебе, SSR, SSG, CSR и гидрация