LSI-ключами в SEO называют слова и фразы, которые часто встречаются рядом с главным запросом: для «перфоратора» это «патрон SDS», «режим долбления», «энергия удара». Сервисы собирают их из текстов топа и советуют вписать в статью. Название взято из латентно-семантического индексирования (Latent Semantic Indexing), метода поиска конца 1980-х. Google о таком факторе говорит прямо: Джон Мюллер в 2019 году написал, что LSI-ключей не существует, а в 2023 году повторил, что они не дают эффекта.
Пользу приносит другое: тематическая полнота. Если статья отвечает на все важные подвопросы темы, нужные термины появляются в ней сами. Ниже разберём, откуда взялся миф, почему списки слов иногда дают результат и чем их заменить.
Коротко
- Патент на метод латентно-семантической структуры US 4,839,853 подан 15 сентября 1988 года и выдан 13 июня 1989 года, научная статья вышла в 1990 году.
- 30 июля 2019 года Мюллер написал: «There's no such thing as LSI keywords», то есть «LSI-ключей не существует».
- 2 января 2023 года на вопрос, куда ставить LSI-ключи, в заголовки или в текст, он ответил: «Both have no effect», то есть никакого эффекта нет ни там, ни там.
- В объяснении Google о ранжировании базовый сигнал релевантности назван прямо: в тексте есть те же слова, что в запросе. Дальше алгоритмы смотрят, есть ли на странице другой полезный контент: для запроса про собак это фото, видео или список пород, а не повтор слова.
- По Wordstat запрос «lsi ключи» вводят чаще, чем главный запрос темы со словом «слова»: 41 и 30 раз в месяц в точной форме.
Что такое латентно-семантическое индексирование
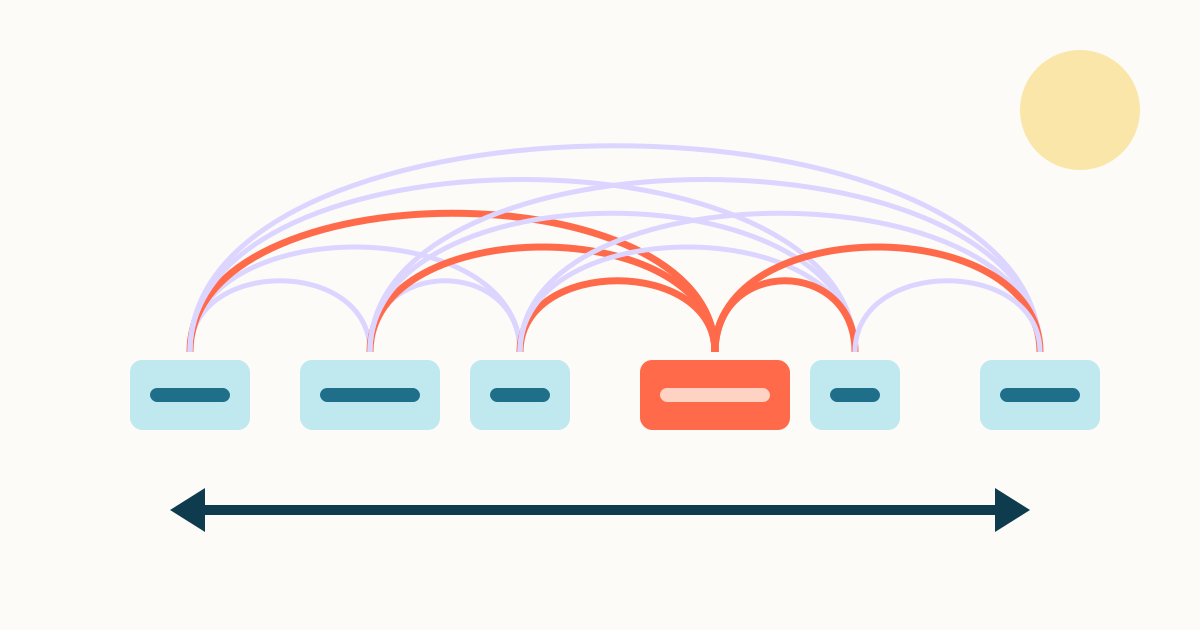
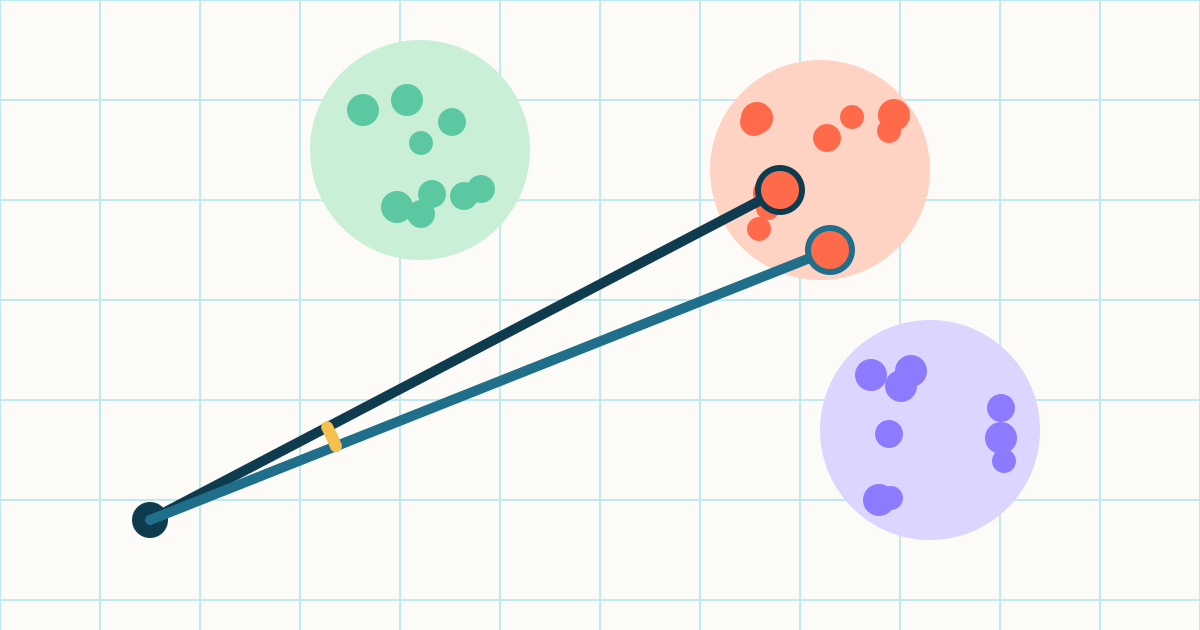
Авторы метода (патент закреплён за Bell Communications Research) решали проблему синонимов: человек ищет «автомобиль», а в документе написано «машина». Обычное совпадение слов такой документ не найдёт. LSI замечает, что оба слова встречаются в похожих контекстах, и сближает их.
Работа «Indexing by Latent Semantic Analysis» вышла в журнале Американского общества информатики в 1990 году (том 41, выпуск 6). В ней описано сингулярное разложение матрицы примерно на 100 ортогональных факторов.
В SEO термин попал по аналогии. Сервисы стали называть «LSI» обычные слова, которые часто стоят рядом с запросом в текстах топа. С исходным методом их роднит только идея, что тема определяется не одним словом.
Что Google говорит про LSI
Хронология:
- 30 июля 2019 года. Мюллер в Twitter: LSI-ключей не существует, а тот, кто утверждает обратное, ошибается.
- 2 января 2023 года. Пользователь спросил, где LSI-ключи работают лучше, в заголовках или в обычном тексте. Ответ: ни там, ни там эффекта нет, и кто советует их использовать, «до сих пор неправ».
Слова сотрудника в соцсети не документация, но они совпадают с тем, что Google пишет официально:
- В объяснении работы поиска сказано, что Google строит языковые модели, чтобы понять смысл нескольких слов запроса, и использует систему синонимов, чтобы находить документы без точного совпадения.
- В руководстве по SEO для начинающих Google приводит пример: одни ищут «charcuterie», другие «cheese board», и системы сопоставления языка понимают, как страница связана со многими запросами. Там же: многократный повтор одних и тех же слов, даже в вариациях, утомляет читателя.
- В правилах о спаме keyword stuffing описан как наполнение страницы ключевыми словами ради позиций, часто списком или вне контекста.
Как поиск научился понимать смысл без LSI, разобрано в статьях про BERT и YATI и про эмбеддинги.
А что в Яндексе?
В рекомендациях для вебмастеров среди примеров контента, к которому алгоритмы могут применить ограничения, есть списки поисковых запросов и многократное повторение и перечисление ключевых слов. Длинный «LSI-абзац», куда вписаны 30 слов из сервиса, легко становится именно таким текстом. Где проходит граница с переспамом и что такое Баден-Баден, разобрано в статье про SEO-текст.
Почему списки слов иногда «работают»
Слова, которые часто стоят рядом с запросом в топе, обычно отражают вопросы читателей. Для «перфоратора» в списке окажутся «SDS-plus», «энергия удара», «режим без удара». Это не «семантические сигналы», а названия того, что человек сравнивает перед покупкой. Статья, которая сравнивает перфораторы по этим параметрам, полезнее той, где их нет.
Отсюда два вывода. Первый: смотреть на такие списки можно, но как на черновой перечень подтем. Второй: проверка «вписаны ли все 40 слов» бессмысленна, потому что поисковик оценивает ответ, а не наличие лексики.
| Что | Когда подходит | Чем платите | Почему важно |
|---|---|---|---|
| LSI-список из сервиса | Быстро увидеть, какие термины используют конкуренты | Деньгами за сервис и риском переспама, если вписывать всё подряд | Полезен только как подсказка подтем, сам список не фактор |
| Подзаголовки статей из топ-10 | Понять, какие подвопросы закрывают лидеры | Временем на ручной разбор 10 страниц | Показывает структуру ответа, а не набор слов |
| Хвосты запросов в Wordstat | Узнать формулировки, которыми люди задают вопросы | Нужно чистить мусор и считать частотность | Каждый частотный хвост это кандидат в раздел или FAQ |
| Поисковые подсказки и блок «Люди также спрашивают» | Найти вопросы, которых нет в Wordstat | Подсказки персонализированы и меняются | Готовые формулировки для H2 и вопросов FAQ |
| Вопросы клиентов и поддержки | Есть отдел продаж, чат или отзывы | Нужен доступ к переписке и время на разбор | Этих вопросов нет у конкурентов, это ваша добавленная ценность |
Что такое тематическая полнота на практике
Пример с одной темой, «посудомоечная машина не сливает воду», в двух подходах.
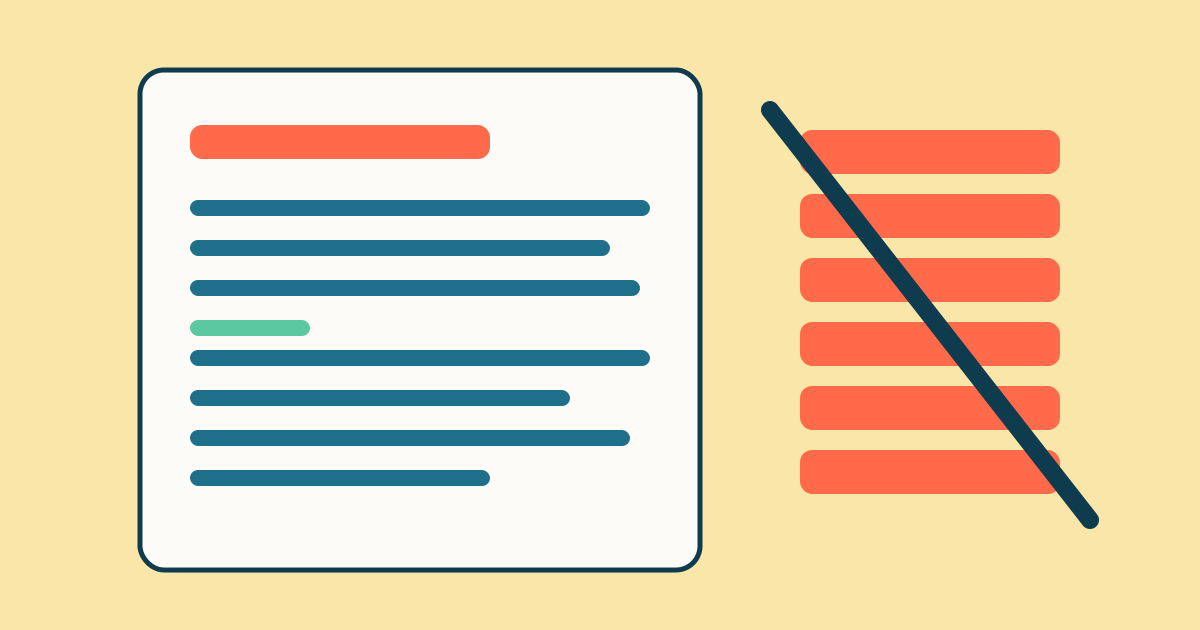
LSI-подход. Сервис выдаёт список: «фильтр», «сливной насос», «шланг», «засор», «ремонт», «мастер», «код ошибки», «крыльчатка». Автор вписывает их в текст, и получается абзац, где каждое слово стоит, но ни на один вопрос нет внятного ответа.
Подход через подвопросы. Автор составляет список того, что человек сделает по порядку: где находится фильтр и как его промыть; как проверить, не пережат ли сливной шланг; как понять по звуку, работает ли насос; что значит код ошибки на дисплее; когда пора звать мастера. Каждый вопрос становится разделом. Слова «фильтр», «насос», «крыльчатка» появляются сами, потому что без них ответить нельзя.
Схема 1. В первом подходе цель это слова, во втором ответы. Термины во втором появляются как следствие.
Полнота важна и для ответов нейросетей. Google пишет, что AI Overviews и AI Mode могут использовать технику query fan-out: выполнять несколько связанных поисков по подтемам. Страница, где подтема раскрыта отдельным разделом с прямым ответом, получает больше шансов попасть в такой ответ. Подробнее в статье про Google AI Overviews. Там же Google отмечает, что специальных оптимизаций для этих функций не требуется.
Как собрать подтемы без «LSI-генераторов»
- Хвосты запроса. В Вордстате посмотрите, с какими словами ищут тему: «как», «почему», «сколько», «чем отличается». Частотные хвосты это кандидаты в разделы.
- Подсказки и вопросы выдачи. Поисковые подсказки и блок «Люди также спрашивают» дают готовые формулировки вопросов.
- Структура топа. Выпишите H2 из 5–10 статей, которые сейчас в топе. Что повторяется у большинства, читатель ждёт и от вас. Как разбирать конкурентов системно, описано в статье про анализ конкурентов.
- Свои данные. Вопросы из чата, звонков, отзывов. Именно это отличает статью от пересказа топа.
- Группировка. Вопросы одного смысла объединяются в раздел. Если группа тянет на отдельный интент, ей нужна своя страница. Принцип тот же, что при кластеризации семантического ядра.
Проверка перед публикацией простая: пройдите по списку подвопросов и найдите в тексте ответ на каждый. Если ответа нет, его не заменит ни одно вписанное слово.
Где граница между полнотой и переспамом
- Полнота: термин стоит в объяснении, и без него фраза теряет смысл.
- Переспам: термин можно удалить, и ничего не изменится.
- Тревожный знак: вы правите текст под процент из сервиса, а не под вопрос читателя.
Метрики вроде «тошноты» и «водности» тоже не измеряют полноту. Что они считают и почему поисковики их не используют, разобрано в статье про воду и тошноту текста.
Наши данные: как часто об этом спрашивают
Методика. Запросы темы и соседних тем кластера «Ключевые слова и семантика» из нашего семантического ядра. Яндекс Wordstat, Россия, 30 дней, срез 14.11.2026. Спрос темы равен сумме точных частот её запросов.
| Запрос или тема | Точная частота, в месяц | Комментарий |
|---|---|---|
| «lsi ключи» | 41 | 57,7% спроса темы |
| главный запрос темы | 30 | 42,3% спроса темы; широкая частота 192 |
| Вся тема LSI | 71 | 0,81% спроса кластера (8 765) |
| Тема «ключевые слова в тексте» | 872 | в 12,3 раза больше, чем тема LSI |
| Тема «ключевые слова» целиком | 4 442 | в 62,6 раза больше |
Что видно:
- Интерес к LSI нишевый. Тема занимает меньше 1% спроса своего кластера. Людей гораздо больше волнует, как расставлять обычные ключи, об этом статья про ключевые слова.
- Точная форма занимает 15,6% широкой. Из 192 запросов с этими словами только 30 вводят ровно в такой форме. Остальное приходится на более длинные фразы с этими словами, то есть на уточнения вокруг темы.
- «Ключи» обгоняют «слова». Термин чаще ищут как разновидность ключевых слов, то есть ожидают от него влияния на позиции. Ответ Google на это ожидание отрицательный.
Кому разбор LSI не нужен
- Карточки товаров и короткие страницы. Там полнота это характеристики, фото и условия доставки, а не лексика.
- Новости и посты. Им важны факт и скорость, а не охват подтем.
- Страницы под один узкий вопрос. Если ответ занимает три абзаца, растягивать его ради списка слов вредно.
Частые вопросы
Что такое LSI-ключи простыми словами?
Это слова, которые часто встречаются рядом с главным запросом в текстах из топа выдачи. SEO-сервисы называют их «LSI» по аналогии с методом латентно-семантического индексирования 1980-х годов, но сам метод к этим спискам отношения не имеет.
Использует ли Google LSI?
Нет. Джон Мюллер в 2019 году написал, что LSI-ключей не существует, а в 2023 году, что они не дают эффекта ни в заголовках, ни в тексте. Google понимает синонимы и связь слов с помощью языковых моделей.
Нужно ли добавлять LSI-ключи в текст?
Вписывать слова ради списка не нужно. Используйте список как подсказку, какие подтемы раскрыли конкуренты, и напишите разделы с ответами на эти вопросы. Нужные термины появятся в тексте сами.
Чем LSI-ключи отличаются от синонимов?
Синоним заменяет слово с тем же смыслом: «автомобиль» и «машина». В LSI-списки попадают любые слова из окружения темы: детали, параметры, действия. Поэтому такой список ближе к перечню подтем, чем к словарю синонимов.
Где брать слова, которые задают тему?
Из хвостов запросов в Wordstat, поисковых подсказок, вопросов в выдаче, подзаголовков статей из топа и вопросов ваших клиентов. Сгруппируйте их по смыслу и превратите группы в разделы статьи.
Источники
- Google: как работает поиск, ранжирование результатов, смысл запроса и релевантность
- Search Engine Roundtable: Мюллер о том, что LSI-ключей не существует (31.07.2019)
- Исходный пост Джона Мюллера в Twitter, 30.07.2019
- Search Engine Roundtable: LSI-ключи не дают эффекта, ответ Мюллера от 02.01.2023
- Руководство Google по SEO для начинающих
- Правила Google в отношении спама: keyword stuffing
- Google Search Central: AI Overviews, AI Mode и query fan-out
- Патент US 4,839,853: поиск информации с использованием латентной семантической структуры
- Deerwester и соавторы, Indexing by Latent Semantic Analysis, JASIS, 1990
- Яндекс: рекомендации по качеству сайтов и примеры нарушений