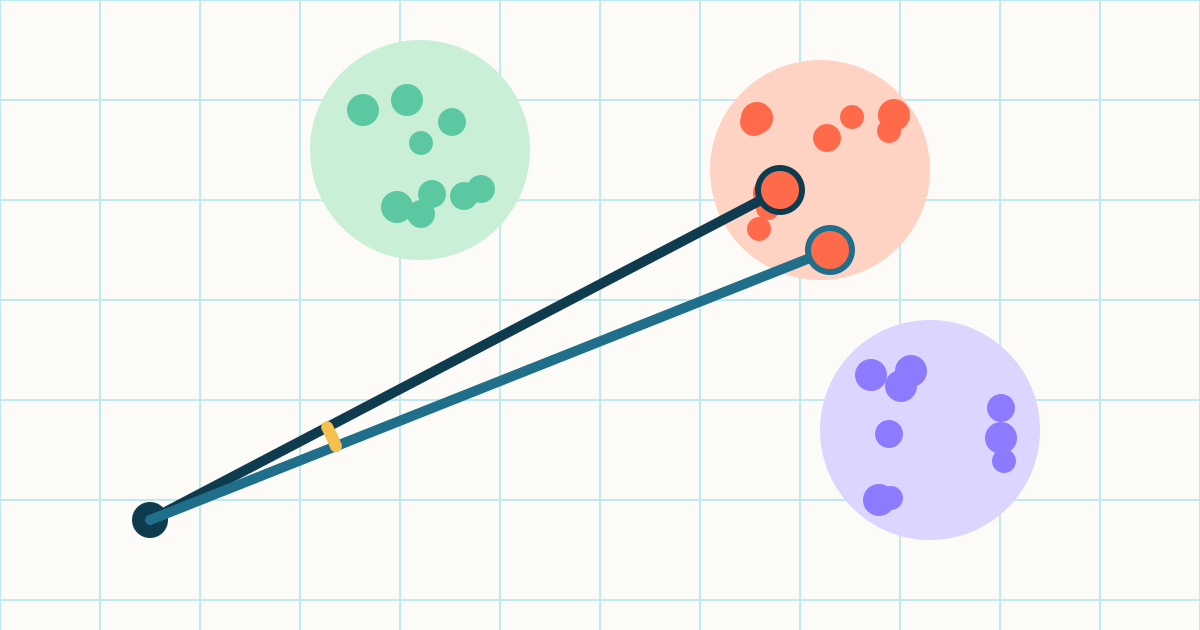
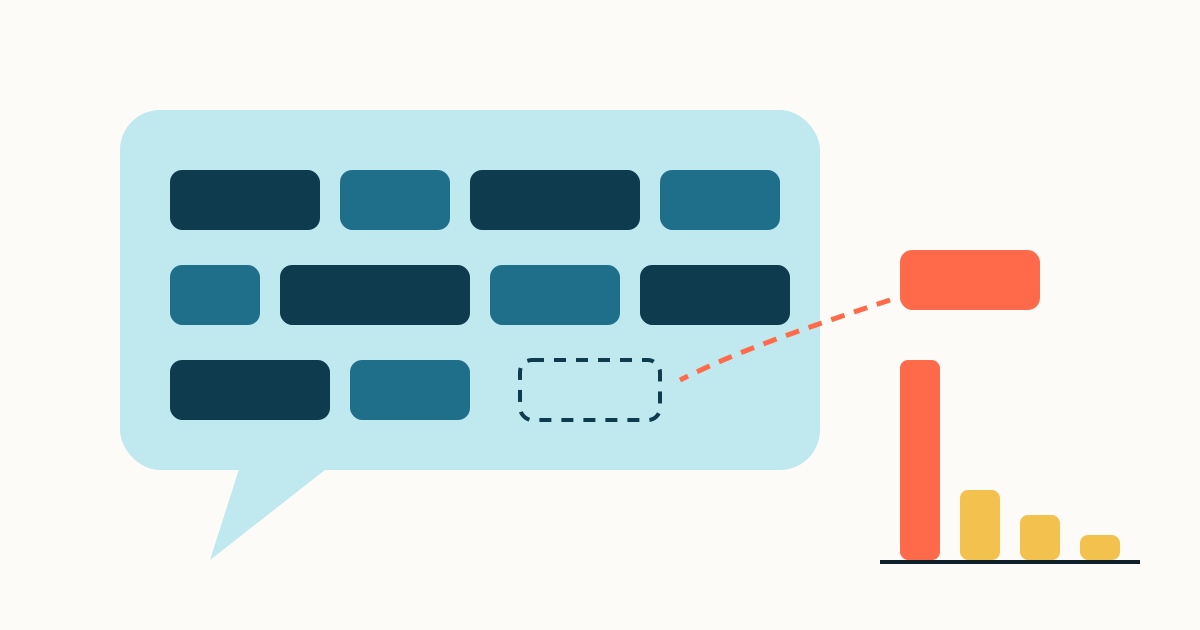
Токен это единица текста, на которую языковая модель режет ваш запрос перед обработкой. Токен может быть целым словом, его частью или одним символом. Модель не видит букв: она получает номера токенов из своего словаря и предсказывает следующий номер. Поэтому в токенах измеряют всё, что важно на практике: сколько текста влезет в один запрос, какой длины может быть ответ и сколько вы заплатите по API.
Коротко
- OpenAI даёт правило для английского: 1 токен примерно 4 символа или три четверти слова. Для русского текста это правило не работает.
- В нашем замере статья на 14 303 символа заняла 6 404 токена в словаре cl100k_base (GPT-4) и 4 074 токена в o200k_base (GPT-4o и новее): на 36% меньше.
- В документации Yandex AI Studio русский текст из 517 символов у YandexGPT Pro дал 5,39 символа на токен: токенизатор Яндекса оптимизирован под русский.
- Контекстное окно включает и запрос, и ответ. У Anthropic в него входят ещё системный промпт, описания инструментов и токены рассуждений.
- Посчитать токены можно бесплатно: Tokenizer в Yandex AI Studio,
POST /tokens/countв GigaChat,count_tokensу Anthropic, библиотека tiktoken у OpenAI.
Как модель режет текст на токены
Большинство современных моделей используют вариант алгоритма BPE (byte pair encoding, кодирование парами байтов). Для обработки текста нейросетями его предложили Рико Сеннрих и соавторы в 2015 году, чтобы переводчик справлялся с редкими словами: слово, которого нет в словаре, разбивается на знакомые части (arXiv: Neural Machine Translation of Rare Words with Subword Units). Словарь строят на обучающих текстах: самые частые пары символов склеивают в новый элемент и повторяют, пока словарь не вырастет до нужного размера.
Отсюда главное свойство: чем чаще последовательность встречалась при обучении токенизатора, тем короче она кодируется. Английское «token» в словарях OpenAI это один токен. Русское «токен» в тех же словарях режется на три: «т», «ок», «ен».
Схема 1. Токен одновременно единица обработки, единица памяти модели и единица оплаты.
Как токены превращаются в векторы, разобрано в статье про эмбеддинги, а весь цикл генерации описан в материале что такое LLM.
Сколько символов в одном токене
Что говорят сами разработчики:
- OpenAI. В справке приводится правило для английского текста: 1 токен примерно 4 символа, или 3/4 слова. Там же сказано, что для других языков соотношение хуже и работа через API обходится дороже (OpenAI Help: What are tokens).
- Anthropic. У прежних моделей Claude токен в среднем соответствовал примерно 3,5 английского символа. Начиная с Claude 4.7 используется новый токенизатор, который даёт примерно на 30% больше токенов на тот же текст (Glossary, Claude Docs).
- Сбер. В документации GigaChat: «в среднем один токен состоит из 3–4 символов» (GigaChat: квоты и ограничения).
- Яндекс. Каждая модель использует свой токенизатор, а токенизатор Яндекса «специально оптимизирован» под русский язык. В примере из документации русский текст на 517 символов дал 5,39 символа на токен у YandexGPT Pro и 4,04 у DeepSeek V4.1 Flash (Yandex AI Studio: токены).
Вывод: сравнивая цены за 1 000 токенов, сравнивайте и токенизаторы. Дешёвая модель с «дробным» словарём для русского может выйти дороже на том же тексте.
Наши данные: замер на русском и английском тексте
Методика. Библиотека tiktoken 0.12.0 от OpenAI, два словаря: cl100k_base (в библиотеке закреплён за GPT-4 и GPT-3.5) и o200k_base (GPT-4o, GPT-4.1, GPT-5). Тексты: абзац о токенах на русском и его английский перевод; полный текст статьи блога MoreSEO о контент-плане без разметки. Замер 15.11.2026.
| Текст | Символов | Токенов, cl100k_base | Токенов, o200k_base | Символов на токен (cl100k / o200k) |
|---|---|---|---|---|
| Абзац на английском | 241 | 49 | 49 | 4,92 / 4,92 |
| Тот же абзац на русском | 210 | 94 | 59 | 2,23 / 3,56 |
| Статья на русском, 2 110 слов | 14 303 | 6 404 | 4 074 | 2,23 / 3,51 |
Что видно из замера:
- Русский дороже по токенам. Один и тот же смысл на русском занял в 1,9 раза больше токенов, чем на английском, в старом словаре и в 1,2 раза больше в новом, хотя символов в русском варианте меньше.
- Новый словарь заметно экономнее. Переход с cl100k_base на o200k_base сократил русскую статью с 6 404 до 4 074 токенов, это минус 36%. В новом словаре 200 019 элементов против 100 277 в старом, поэтому больше русских слов и их частей кодируются одним токеном.
- На слово уходит 2–3 токена. В старом словаре 3,04 токена на русское слово, в новом 1,93. Правило «токен равен трём четвертям слова» для русского текста ошибается в 2–4 раза.
- Как режется «нейросеть». В cl100k_base слово делится на пять частей: «н», «ей», «рос», «ет», «ь». В o200k_base на три: «ней», «рос», «еть». Английское «token» в обоих словарях остаётся одним токеном.
Спрос по теме небольшой: дословную формулировку «токен это в нейросети это часть текста» вводят 15 раз в месяц при широкой частотности 194, то есть точная фраза даёт 7,7% хвоста (Wordstat, Россия, 30 дней, срез 14.11.2026). Чаще вопрос о токенах всплывает внутри брендовых запросов: например, «гигачат токены» входит в группу тем о тарифах GigaChat.
Что такое контекстное окно и что в него входит
Anthropic формулирует это прямо: окно включает «весь текст, на который модель может опереться при генерации ответа, включая сам ответ». В расчёт идут системный промпт, все сообщения с результатами инструментов, изображениями и документами, описания инструментов и токены рассуждений (Context windows, Claude Docs). Если вход уже больше окна, API возвращает ошибку 400 «prompt is too long».
Размеры окон на 15.11.2026:
- текущие модели Claude: 1 млн токенов, до 128 тыс. токенов ответа за один запрос (там же);
- Alice AI LLM в Yandex AI Studio: 131 072 токена, YandexGPT Pro 5.1: 32 768 (Yandex AI Studio: модели).
Большое окно не значит, что модель одинаково хорошо помнит всё, что в нём лежит. В документации Anthropic отдельно сказано: с ростом числа токенов точность и полнота извлечения падают, и этот эффект называют context rot. Поэтому длинный документ полезнее не загружать целиком, а подавать нужные фрагменты. На этом построен подход RAG: модель получает только относящиеся к вопросу куски из базы знаний.
Как считается цена за токены
Пример цен российских провайдеров на 15.11.2026, рубли за 1 000 токенов с НДС:
| Модель | Вход | Выход | Источник |
|---|---|---|---|
| GigaChat Lite (юрлица, по факту) | 0,065 | 0,065 | тарифы Сбера; минимальный платёж 600 ₽ в месяц |
| GigaChat Max (юрлица, по факту) | 0,65 | 0,65 | тарифы Сбера |
| YandexGPT Lite | 0,2 | 0,2 | тарифы Yandex AI Studio |
| Alice AI LLM | 0,5 | 1,2 | тарифы Yandex AI Studio |
Источники: тарифы GigaChat API для юрлиц (страница обновлена 07.10.2026) и тарифы Yandex AI Studio. У Сбера одна цена без разделения на вход и выход. Асинхронный режим у обоих дешевле. Подробно о подключении, ключах и шлюзах написано в статье про API нейросетей.
Как прикинуть цену одной задачи. Допустим, вы генерируете статью на 14 000 символов. При 3–4 символах на токен (ориентир Сбера) это примерно 3 500–4 700 исходящих токенов. На GigaChat Lite такой ответ стоит около 0,3 ₽. По той же оценке Alice AI LLM даст 4–6 ₽, а на деле, вероятно, меньше: в примере из документации Яндекса на один токен приходится больше русских символов. К этому добавьте вход: промпт, бриф, вставленные источники. Длинный документ в каждом запросе легко делает вход дороже выхода.
Что ещё влияет на счёт:
- История диалога. С каждым сообщением модель заново получает всю переписку, и вы снова платите за неё как за вход.
- Кеширование. Повторяющееся начало запроса провайдеры кешируют, у Яндекса для таких токенов отдельная строка тарифа, но кеширование «не гарантируется».
- Рассуждения. У Anthropic токены размышления входят в
max_tokensи оплачиваются как исходящие.
Как посчитать токены до отправки запроса
| Что | Когда подходит | Чем платите | Почему важно |
|---|---|---|---|
| Tokenizer в Yandex AI Studio | Работаете с моделями Яндекса | Ничего: вызовы токенизатора не тарифицируются, нужна роль ai.languageModels.user | Считает именно тем словарём, по которому будет счёт |
POST /tokens/count в GigaChat API | Оцениваете расход у Сбера | Время на интеграцию | Соотношение 3–4 символа на токен у Сбера только среднее |
count_tokens у Anthropic | Claude, длинные промпты, инструменты, PDF | Бесплатно, но с лимитом запросов в минуту; результат оценочный | Учитывает системный промпт, инструменты и изображения |
| Библиотека tiktoken | Модели OpenAI, офлайн-подсчёт больших объёмов | Установка Python-библиотеки | Работает без сети после загрузки словаря, удобно для пакетов текстов |
| Поле usage в ответе | Любой провайдер, контроль фактического расхода | Ничего, но узнаёте уже после запроса | Единственная цифра, которая совпадает со счётом |
Anthropic отдельно предупреждает: при переходе на модель с новым токенизатором старые подсчёты не годятся, промпт нужно пересчитать (Token counting, Claude Docs).
Токены не равны символам из счётчиков для копирайтеров. Если заказчик считает текст в знаках, используйте подсчёт символов, а для бюджета API пересчитывайте токенизатором.
Как тратить меньше токенов
- Короткая постоянная инструкция. Системный промпт повторяется в каждом запросе: сократив его с 2 000 до 500 токенов, вы убираете 1 500 токенов из каждого вызова.
- Фрагменты вместо документов. Меньше лишнего в контексте, меньше и счёт, и ошибок.
- Явный объём ответа. «Ответь в пяти пунктах» экономит выход, а max_tokens страхует от слишком длинного ответа.
Как формулировать короткие и точные запросы, разобрано в статье что такое промпт. Если хочется не платить за токены вовсе, посмотрите локальные LLM: там токены тоже есть, но расплачиваетесь вы памятью и временем своего компьютера.
Кому это не нужно
Достаточно знать одно: очень длинная переписка «забывается», поэтому под новую задачу начинайте новый диалог. А при выборе модели для текстов качество важнее цены токена: прогоните свои задания через 2–3 модели, как в статье ChatGPT, Claude, Gemini или DeepSeek.
Частые вопросы
Токен это слово или часть слова?
Чаще всего часть слова. Короткие частые слова могут быть одним токеном, длинные и редкие делятся на несколько частей, пробелы и знаки препинания тоже кодируются. В нашем замере русское слово в среднем занимало 2–3 токена в зависимости от словаря.
Сколько токенов в 1 000 символов русского текста?
Зависит от модели. В словаре o200k_base у OpenAI около 285 токенов (3,51 символа на токен), в старом cl100k_base около 450. У YandexGPT Pro в примере из документации около 185. Точное число покажет токенизатор выбранной модели.
Почему русский текст стоит дороже английского?
Токенизаторы обучают на текстах, где английского больше, поэтому английские слова чаще попадают в словарь целиком, а русские режутся на части. Один и тот же смысл на русском даёт больше токенов, а платите вы именно за токены. У российских моделей словари оптимизированы под русский, и разрыв меньше.
Входит ли ответ модели в контекстное окно?
Да. Окно включает весь запрос с историей и инструкциями плюс сгенерированный ответ, а у моделей с размышлением ещё и токены рассуждений.
Где бесплатно посчитать токены?
Tokenizer в Yandex AI Studio и подсчёт токенов у Anthropic бесплатны, у GigaChat есть метод POST /tokens/count, для моделей OpenAI подойдёт открытая библиотека tiktoken. Фактический расход любой провайдер возвращает в поле usage ответа.
Источники
- OpenAI Help: What are tokens and how to count them
- Claude Docs: глоссарий, токены и новый токенизатор
- Claude Docs: что входит в контекстное окно
- Claude Docs: бесплатный подсчёт токенов
- Yandex AI Studio: что такое токены и как их посчитать
- Yandex AI Studio: модели и размер контекста
- Yandex AI Studio: тарифы на генерацию текста
- GigaChat API: квоты, ограничения и подсчёт токенов
- GigaChat API: тарифы для юридических лиц
- Sennrich, Haddow, Birch: BPE для редких слов (arXiv, 2015)
- Библиотека tiktoken от OpenAI на GitHub